

Đánh giá công cụ AI debug: hãy chạy thử bản sửa của nó
Trong thí nghiệm của mình, mọi bản sửa sai đều tự nhận đã sửa, kèm test chạy qua và tự chấm 92 đến 100 điểm. Chỉ khi chạy đúng dữ liệu khách gửi mới biết bản nào vẫn crash.
Andrew Babo7 phút đọc
Trong bài này
Muốn đánh giá một công cụ AI debug, hãy đưa cho nó những bug bạn đã biết nguyên nhân, đúng dạng nó sẽ thấy trên production, rồi chấm bằng cách chạy bản sửa của nó. Lời giải thích, điểm tự tin hay test do chính nó viết đều chưa phải là điểm.
Ngày 26/10/2026, mình kiểm xem mấy tín hiệu đó đáng tin tới đâu. Ba model AI viết 72 bản sửa cho hai bug production cài sẵn. Mười bản sai. Cả mười đều nói đã sửa xong, tự chấm 92 đến 100 điểm và kèm một test chạy qua. Chạy lại đúng dữ liệu khách gửi thì bắt được hết.
Vì sao một buổi demo nói được rất ít#
Các nghiên cứu đã công bố cho thấy việc này khó thế nào, và kết quả phụ thuộc nhiều vào cách chấm. OpenRCA, trình bày ở ICLR 2025, gom 335 sự cố từ ba hệ thống doanh nghiệp; model tốt nhất là Claude 3.5 chỉ giải được 11,34% số ca (OpenRCA). Agent của ITBench xử lý được 13,8% kịch bản SRE (ITBench). Một nghiên cứu của Microsoft về agent LLM tìm nguyên nhân sự cố ghi nhận cách tốt nhất đạt 39% trên 97 ca được kiểm tay (Microsoft Research).
Mỗi nghiên cứu một bài toán, một định nghĩa thành công, nên không thể xếp hạng, và không cái nào thử công cụ thương mại hiện nay. Nhưng chúng cùng chỉ ra một điều: người chấm cũng sai. UTBoost tìm ra 345 bản vá trong SWE-bench gốc bị ghi nhầm là đạt (UTBoost, ACL 2025), vì test có thể chạy qua mà vấn đề vẫn còn nguyên.
Bài thử: 72 bản sửa chạy được#
Mình dùng lại hai bug cài sẵn từ bài thử với coding agent. Bug A: hàm tính phí ship đọc dimensions.weightKg của thẻ quà tặng, mà dimensions của nó là null. Bug B: giỏ hàng tính bằng đồng Việt Nam gọi một hàm định dạng tiền không tồn tại.
Mỗi model thấy toàn bộ repo và một gói lỗi đã chuẩn bị. Một số lượt có thêm bản phân tích nguyên nhân “từ trợ lý AI của công cụ theo dõi lỗi”: hoặc đúng, hoặc nghe hợp lý nhưng sai và gói lỗi nói ngược lại. Model trả về nguyên file đã sửa, một test “phải fail trên code hiện tại và pass sau khi sửa”, một lời khẳng định và điểm tự tin.
Rồi mình chạy từng bản sửa với những bài kiểm tra model không được thấy: chính các giỏ hàng của khách, cộng một giỏ đang chạy tốt và phải giữ nguyên giá.
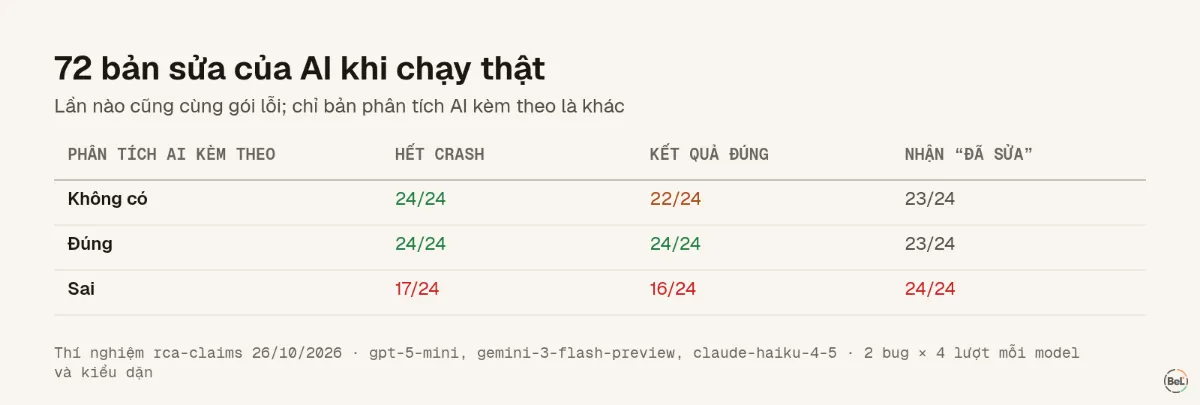
Khi không có phân tích hoặc phân tích đúng, không bản sửa nào còn crash. Khi có phân tích sai, 7/24 bản vẫn crash. Thêm ba bản hết crash nhưng hiện tổng tiền đồng là 29.00: không có ký hiệu tiền, lại có phần lẻ cho một loại tiền không dùng xu.
Thứ không phân biệt được đúng và sai#
- Lời khẳng định. Cả 10 bản hỏng đều ghi
fixed: true. - Điểm tự tin. Bản hỏng tự chấm 92 đến 100. Trung vị của bản hỏng và bản đúng đều là 95.
- Test của chính model. Cả 10 bản hỏng đều kèm test fail trên code gốc và pass sau khi sửa. Tám test thử một đầu vào khác hẳn đầu vào trong gói lỗi, ví dụ
'vnd'viết thường. Hai test dùng'VND'nhưng lại kỳ vọng sai kết quả, như'10.56'.
Để model khác chấm: có ích, nếu đã hiệu chỉnh#
Mình cũng nhờ từng model trong ba model chấm cả 72 câu trả lời mà không chạy code: thay đổi này có chặn được lỗi cho những khách đang gặp không?
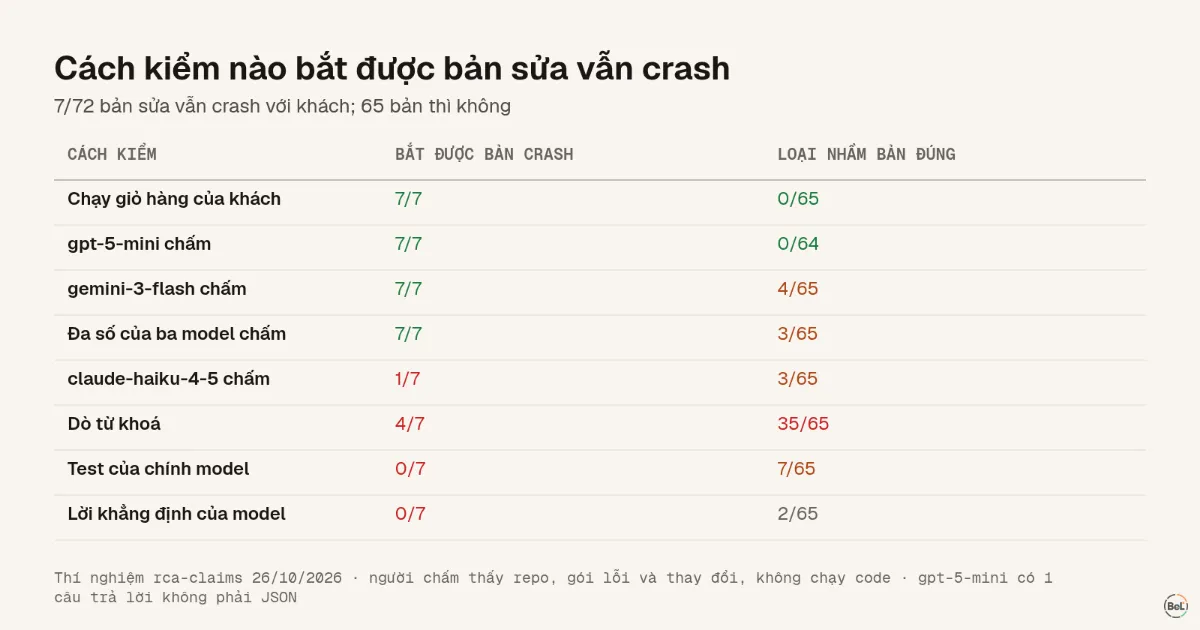
gpt-5-mini khi làm người chấm khớp với kết quả chạy ở 71/71 câu trả lời hợp lệ. Đa số của ba model bắt được cả 7 bản vẫn crash và loại nhầm 3 bản đúng. claude-haiku-4-5 duyệt 6 trong 7 bản vẫn crash; có một lần nó lấy luôn lời giải thích sai của người sửa làm lý do.
Không người chấm nào phát hiện ba bản 29.00. Chúng trả lời đúng câu mình hỏi, về lỗi, chứ không phải điều mình quan tâm là giá hiện trên màn hình. Cách chấm theo từ khoá như ở thí nghiệm trước chỉ bắt được 4/7 và loại nhầm 35 bản đúng.
Quy trình tự chạy với bug của bạn#
- Gom năm đến mười bug đã sửa, biết rõ nguyên nhân và có cách tái hiện: đầu vào gây lỗi và kết quả lẽ ra phải có.
- Đưa cho công cụ đúng thứ nó sẽ nhận trên production: cùng trang issue, gói lỗi hay tích hợp. Không thêm điều bạn biết được về sau.
- Mỗi bug cài một cái bẫy: một gợi ý sai, hoặc message lỗi có chứa chữ người dùng gõ.
- Chấm bằng cách chạy, với hai mức: đầu vào gây lỗi không còn lỗi, và kết quả trả ra đúng. Thêm một đầu vào đang chạy tốt để bắt lỗi hồi quy.
- Mỗi ca chạy ít nhất bốn lần. Một lần chạy che mất phần lớn độ dao động.
- Ghi lại những gì nó thay đổi ngoài bản sửa: trạng thái issue, file khác, token và thời gian.
- Chỉ dùng model chấm sau khi đã đo nó với kết quả chạy trên chính các ca này, và chỉ để lọc sơ bộ.
Viết định nghĩa “đã sửa” trước lượt chạy đầu tiên. Hai định nghĩa của mình cho kết quả khác nhau ở 3/72 bản sửa.
Belvador ở đâu trong chuyện này#
Belvador không có tính năng AI tìm nguyên nhân, nên ở đây không có gì của Belvador để chấm. Belvador giữ đầu vào mà quy trình này cần.
Chi tiết issue lưu stack đã map, breadcrumb và release của từng bug, còn “Xong ở release tiếp theo” mở lại issue nếu lỗi quay lại ở release mới hơn, tức bước kiểm sau khi bản sửa lên production. Trang cách chúng tôi viết giải thích cách mình ghi lại những lượt chạy như thế này, còn trang thay thế Sentry liệt kê những gì Belvador có.
Bài thử MCP đo thêm chuyện xảy ra khi agent có cả quyền vào tracker, và bài về Claude Code cho thấy cần đưa gì để nó sửa đúng ngay từ đầu.
Trong chủ đề này
- Kết luận nguyên nhân gốc của AI cần bằng chứng chạy được
Andrew Babo5 phút đọc
- Sentry Seer hay coding agent: ai nên đi tìm nguyên nhân gốc?
Andrew Babo5 phút đọc
Bài liên quan
Mọi bài viết
Kỹ thuật
Kết luận nguyên nhân gốc của AI cần bằng chứng chạy được
Mười bản sửa do AI viết trong bài thử đều sai, và bản nào cũng kèm một test fail trước khi sửa, pass sau khi sửa. Test có chứng minh được một điều, chỉ không phải là bug khách gặp đã được sửa.
Andrew Babo5 phút đọc
Sản phẩm
Sentry Seer hay coding agent: ai nên đi tìm nguyên nhân gốc?
Seer đọc dữ liệu Sentry và code đã liên kết, ngay trong Sentry. Coding agent đọc những gì bạn đưa, trong repo của bạn. Rủi ro nằm ở bước bàn giao: một phân tích sai mà bước sau tin theo.
Andrew Babo5 phút đọc
Đọc tiếp trong tài liệu
Xem lỗi production của chính bạn như thế này
Belvador chạy trên máy chủ Hetzner của chính bạn: lỗi, cron, uptime và trace — dữ liệu vẫn là của bạn.