

Cron job chạy mãi không xong: heartbeat thật ra nhìn thấy gì?
Mình dừng một job bằng SIGTERM và SIGKILL, mỗi kiểu ba lần. Một cách gửi ping rất phổ biến báo “thành công” cho job đã bị giết.
Andrew Babo7 phút đọc
Trong bài này
Hãy gửi heartbeat từ chính dòng cron khởi động job, đừng gửi từ bên trong job, và đặt cho monitor một thời gian chạy tối đa. Trong thí nghiệm của mình, ping gửi từ EXIT trap trong script bash báo thành công cho một job đã bị SIGTERM dừng, cả 3/3 lần. Cùng job đó, ping từ dòng cron báo đúng mã thoát thật: 143 hoặc 137.
Chỉ có một trường hợp không còn ping cuối nào: cả dòng cron bị giết. Khi đó, thứ duy nhất báo động cho bạn là kiểm tra thời gian chạy tối đa.
Job định kỳ có thể chết theo bốn kiểu#
Một heartbeat monitor (còn gọi là dead man's switch) chỉ biết ping nào đã đến và đến lúc nào. Vậy nên trước khi quyết định ping gửi từ đâu, nên liệt kê xem job có thể gặp chuyện gì:
- Lỗi. Script thoát với mã khác 0. Dễ báo, miễn là còn thứ gì đó đang chạy để báo.
- Bị dừng. Có thứ gửi SIGTERM:
timeout, systemd hết thời gian dừng unit,docker stop, một lần deploy khởi động lại máy. Trang manual của timeout(1) ghi rõ: "Upon timeout, send the TERM signal to COMMAND, if no other SIGNAL specified." - Bị giết. SIGKILL không bắt được. OOM killer dùng nó,
kill -9dùng nó, và systemd gửi nó cho mọi tiến trình còn sót sau thời gian chờ dừng (systemd.kill). - Không chạy, hoặc chạy mãi. Máy chết, dòng crontab bị mất khi chuyển server, hoặc job đứng chờ một lock hay một lời gọi mạng không bao giờ trả về.
Ba kiểu đầu còn một tiến trình có thể kịp gửi ping cuối, hoặc không. Kiểu thứ tư thì chẳng còn ai để gửi.
Thí nghiệm#
Mình muốn có số đo thay vì đoán, nên chạy một thí nghiệm nhỏ ngày 25/10/2026. Một HTTP receiver chạy trên 127.0.0.1 ghi lại mọi ping kèm thời điểm. Job ngủ 20 giây và bị dừng ở giây thứ 2. Mỗi trường hợp chạy ba lần. Phiên bản: GNU bash 5.3.3, dash 0.5.13.1, curl 8.18.0, Python 3.13.12, trên sandbox Linux 4.19 (gVisor). Không dùng ping URL thật nào.
Phần một gửi ping từ bên trong job, đúng kiểu nhiều script vẫn viết:
#!/usr/bin/env bash# job2.sh <kiểu> <số giây> — chỉ ping tới receiver cục bộset -uV="$1"; WORK="$2"; PING="http://127.0.0.1:8765/hb/$V"ping() { curl -fsS -m 10 -o /dev/null "$PING/$1" || true; }ping startcase "$V" in naive) trap 'ping $?' EXIT sleep "$WORK" ;; term-trap) trap 'ping fail; exit 143' TERM INT trap 'ping $?' EXIT sleep "$WORK" ;; term-wait) trap 'ping fail; exit 143' TERM INT trap 'ping $?' EXIT sleep "$WORK" & wait $! ;;esacPhần hai gửi ping từ bên ngoài, ngay trên dòng mà cron chạy, với cả bash lẫn dash (Debian và Ubuntu chạy dòng cron bằng dash):
curl -fsS -m 10 -o /dev/null "$P/start"; ./work.sh; curl -fsS -m 10 -o /dev/null "$P/$?"Kết quả nhận được#
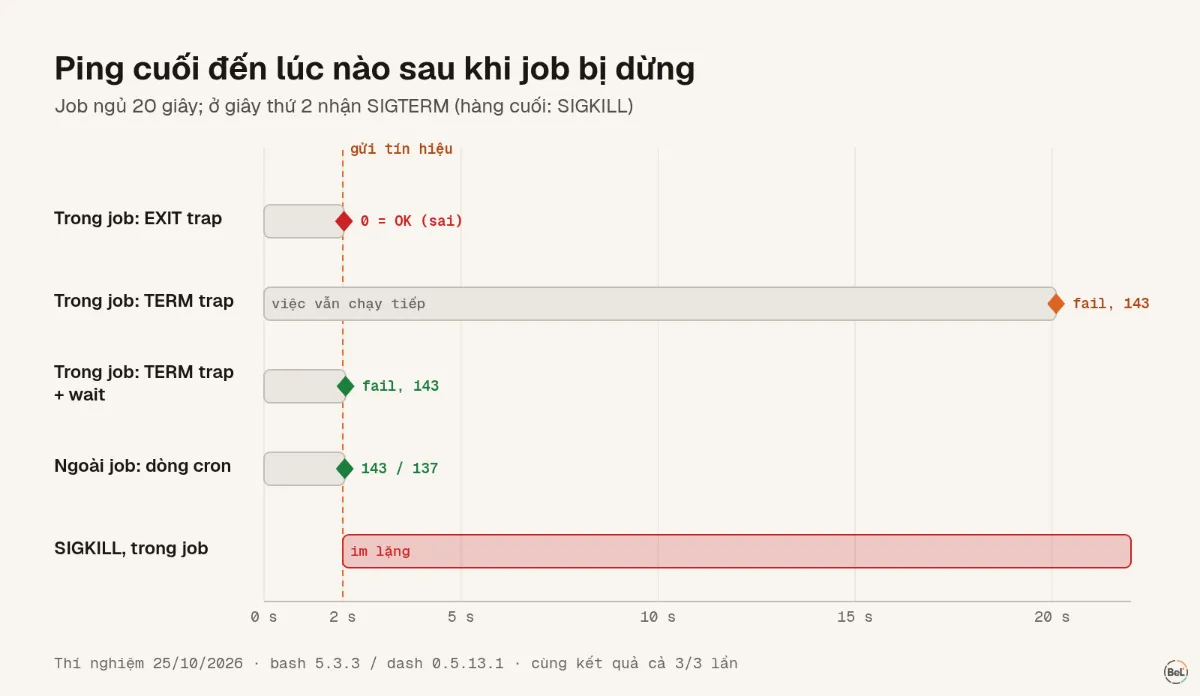
Cả ba lần lặp của mọi trường hợp đều cho cùng một chuỗi ping.
| Ping cuối gửi từ đâu | Job bị dừng (SIGTERM) | Job bị giết (SIGKILL) |
|---|---|---|
Trong job, chỉ có EXIT trap | start, rồi 0: bị coi là thành công | chỉ start |
| Trong job, có TERM trap, việc chạy foreground | start, fail, 143, nhưng 18,1 giây sau tín hiệu | chỉ start |
Trong job, có TERM trap, việc chạy qua wait | start, fail, 143, 0,07 giây sau tín hiệu | chỉ start |
| Ngoài job, trên dòng cron (bash và dash) | start, 143 | start, 137 |
| Cả dòng cron bị giết | — | chỉ start |
EXIT trap báo một job bị giết là khoẻ#
Bash vẫn chạy trap khi SIGTERM kết thúc script, nhưng $? bên trong trap lại giữ mã của lệnh cuối cùng đã chạy xong, tức là lệnh ping start, bằng 0. Monitor nào tin vào mã thoát sẽ đánh dấu lần chạy đó là ổn. Log của job cũng không nói gì khác, vì job chưa kịp ghi dòng nào.
TERM trap phải đợi lệnh foreground chạy xong#
Khi phần việc chính chạy ở foreground, trap chỉ chạy khi sleep kết thúc, tức 18 giây sau. Điều này khớp với manual của bash: nếu bash "receives a signal for which a trap has been set, it will not execute the trap until the command completes." Cùng trang đó có luôn cách sửa: khi bash đang chờ qua lệnh wait, wait trả về ngay với mã lớn hơn 128 và trap được chạy. Trong một lần dừng thật, 18 giây thường dài hơn thời gian ân hạn, nên trap sẽ bị SIGKILL cắt ngang và không bao giờ chạy.
Không gì bên trong job sống sót qua SIGKILL#
Mọi kiểu ping từ trong job đều gửi start rồi im bặt. Còn khi ping từ dòng cron, shell chạy dòng đó vẫn sống và báo 137, mã của tiến trình bị giết bằng tín hiệu số 9.
Ai còn sống để gửi ping cuối?#
Nhìn dưới dạng cây tiến trình sẽ dễ hiểu hơn. Cron mở một shell cho dòng lệnh, shell đó mới chạy job của bạn. Thứ gửi ping cuối phải sống lâu hơn job.
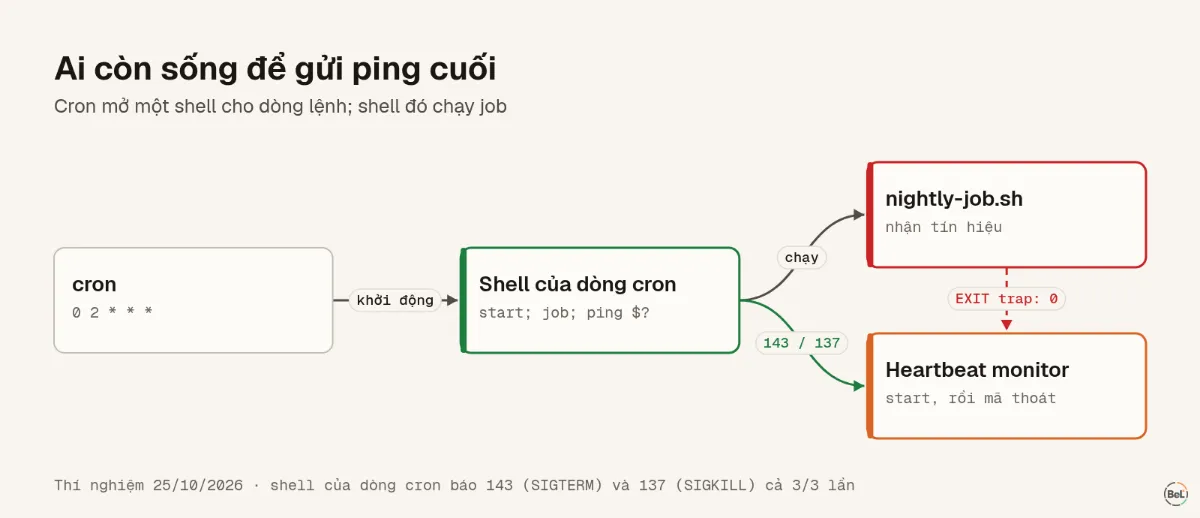
Từ đó, cách thiết lập đã đứng vững trong thí nghiệm:
# crontab: ping start, chạy job, rồi gửi mã thoát (0 = OK, 1–255 = lỗi)0 2 * * * curl -fsS -m 10 --retry 5 -o /dev/null "$PING_URL/start" ; /usr/local/bin/nightly-job.sh ; curl -fsS -m 10 --retry 5 -o /dev/null "$PING_URL/$?"Nếu bắt buộc job phải tự gửi ping, hãy đặt phần việc chính sau wait và bắt TERM rõ ràng, như kiểu term-wait. Sau đó thêm thời gian chạy tối đa trên monitor cho những gì trap không bao giờ thấy được.
Những gì heartbeat vẫn không thấy#
Còn hai lỗ hổng, và không kiểu ping nào bịt được.
Lỗ hổng thứ nhất là dòng cuối của bảng: cả dòng cron chết, ví dụ container bị kill hoặc máy khởi động lại. Monitor nhận start rồi không còn gì nữa. Chỉ có thời gian chạy tối đa mới biến sự im lặng đó thành cảnh báo, vì vậy hãy đặt nó dài hơn một chút so với lần chạy khoẻ chậm nhất của bạn.
Lỗ hổng thứ hai là job thoát với mã 0 mà chẳng làm được gì, ví dụ một lần export ghi ra 0 dòng. Heartbeat đo việc job đã chạy, không đo việc job chạy đúng. Nếu kết quả quan trọng, hãy cho job thoát với mã khác 0 khi kết quả rỗng, hoặc gửi kèm số dòng trong ping để thấy nó ngay trong lần chạy.
Belvador giúp ở đâu#
Ping URL monitor của Belvador dùng đúng khuôn như thí nghiệm: gọi /start khi job bắt đầu, rồi gọi URL gốc khi thành công, /fail, hoặc gắn mã thoát làm hậu tố (/143). Lần chạy đã gọi /start mà vẫn mở sau thời gian chạy tối đa (mặc định 30 phút) bị tính là lỗi. Lần chạy không hề bắt đầu sẽ bị đánh dấu khi đã qua lịch chạy cộng thời gian trễ cho phép (mặc định 5 phút).
Hạn chót được giữ ở edge, nên cảnh báo vẫn đi khi chính server của bạn là thứ đã chết. Tài liệu ping URL liệt kê mọi hậu tố và trạng thái; nếu bạn đang dùng cron monitor của Sentry SDK, xem check-in từ Sentry SDK. Trang theo dõi cron giải thích phần này nằm ở đâu trong Belvador.
Đọc tiếp#
- Giám sát agent chạy trên serverless, bài tổng quan chứa thí nghiệm này.
- Burn rate trong SLO, giải thích dễ hiểu, để một lần chạy lỗi không đánh thức bạn hai lần.
- Chuyển từ Sentry SDK: checklist kiểm từng giả định, nếu cron của bạn đang gửi check-in qua Sentry.
Thuộc bài hướng dẫn: Giám sát AI agent chạy trên serverless function
Bài liên quan
Mọi bài viết
Hướng dẫn
Giám sát AI agent chạy trên serverless function
Một lần chạy agent trên serverless là một chuỗi lần gọi ngắn, mỗi lần có giới hạn thời gian riêng. Bài này chỉ ra cần theo dõi gì ở từng mắt xích, kèm ba thí nghiệm nhỏ cho thấy tín hiệu bị mất ở đâu.
Andrew Babo8 phút đọc
Kỹ thuật
Job thử lại, lỗi bị báo trùng: mỗi lần thử gửi gì cho công cụ theo dõi lỗi
Mình cho một job thanh toán hỏng rồi thử lại bằng SDK Node của Sentry và đếm từng event. Mười job hỏng gửi 30 event, job đã hồi phục vẫn gửi 2. Dedupe không cứu được.
Andrew Babo8 phút đọc
Đọc tiếp trong tài liệu
Xem lỗi production của chính bạn như thế này
Belvador chạy trên máy chủ Hetzner của chính bạn: lỗi, cron, uptime và trace — dữ liệu vẫn là của bạn.