

Giám sát AI agent chạy trên serverless function
Một lần chạy agent trên serverless là một chuỗi lần gọi ngắn, mỗi lần có giới hạn thời gian riêng. Bài này chỉ ra cần theo dõi gì ở từng mắt xích, kèm ba thí nghiệm nhỏ cho thấy tín hiệu bị mất ở đâu.
Andrew Babo8 phút đọc
Trong bài này
Hãy coi mỗi lần gọi serverless là một bước của lần chạy agent. Ở mỗi bước, theo dõi ba thứ: lỗi kèm cùng một trace id cho cả lần chạy, lần chạy có bắt đầu và kết thúc đúng hạn không, và những lỗi code tự bắt hoặc giao cho việc chạy nền. Loại lỗi cuối cùng không bao giờ tới được handler, nên dễ bị bỏ sót nhất.
Một agent biết lập kế hoạch, gọi tool, chờ rồi thử lại hiếm khi gói gọn trong một lần gọi function. Nó thành một chuỗi: handler nhận request, consumer đọc queue, cron Worker đánh thức những lần chạy bị kẹt, và một tool nằm sau một lời gọi HTTP khác. Mắt xích nào cũng có thể hỏng riêng, và mỗi mắt xích lại có cách hỏng âm thầm của riêng nó.
Vì sao agent trên serverless hỏng theo kiểu khác#
Một server chạy lâu dài giữ bộ nhớ và log ở cùng một chỗ. Agent trên serverless thì không. Lần chạy của nó trải ra qua nhiều lần gọi, mỗi lần khởi động lạnh, kết thúc khi hết hạn và không chia sẻ gì ngoài những thứ bạn tự truyền đi.
Từ đó sinh ra ba vấn đề.
- Lần chạy dài hơn bất kỳ bước nào. Nếu một bước bị dừng vì hết giới hạn, không gì bên trong bước đó báo được việc này.
- Các bước không biết chúng thuộc cùng một lần chạy. Không có id chung, lỗi ở tool và lỗi ở bước agent trông như hai issue chẳng liên quan.
- Nhiều việc diễn ra sau khi đã trả phản hồi. Việc chạy nền chính là nơi lỗi bị nuốt mất.
Biết hạn chót của từng bước#
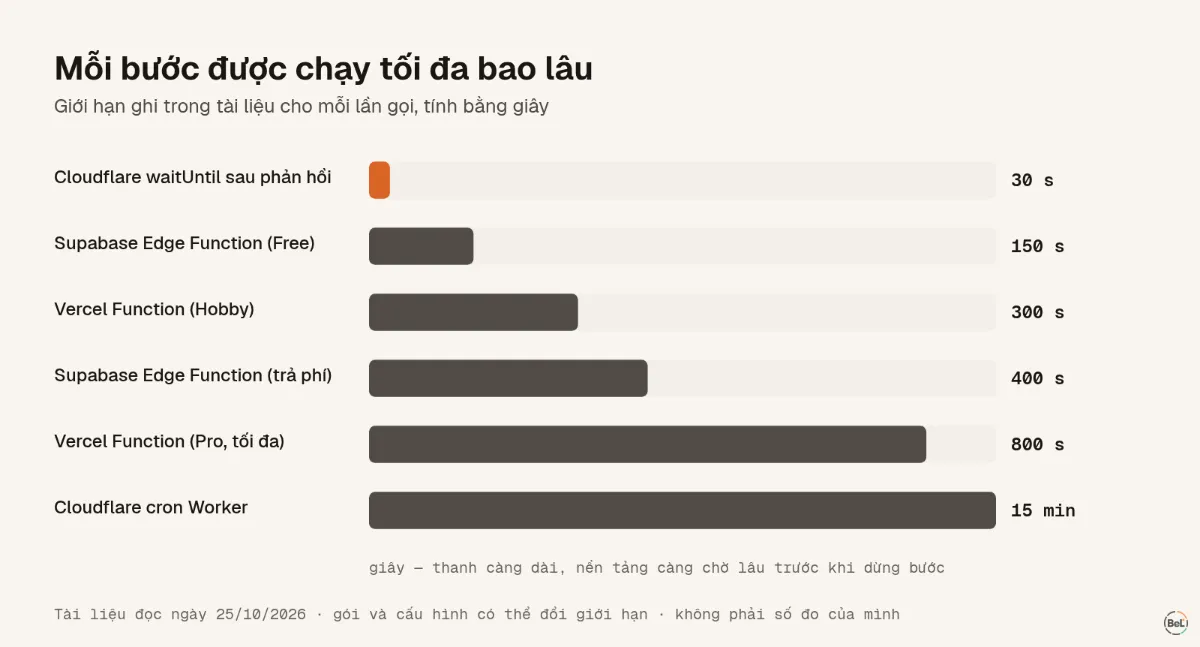
Trước khi chọn theo dõi gì, hãy ghi ra mỗi bước được chạy tối đa bao lâu. Dưới đây là các giới hạn mình đọc trong tài liệu ngày 25/10/2026. Chúng thay đổi theo gói và cấu hình, nên bạn nhớ kiểm lại của mình.
| Kiểu bước | Giới hạn theo tài liệu |
|---|---|
Việc giao cho waitUntil của Cloudflare sau khi trả phản hồi | tối đa 30 giây, sau đó promise chưa xong bị huỷ (context API) |
| Cloudflare cron (scheduled) Worker | 15 phút wall time mỗi lần gọi (giới hạn Cloudflare) |
| Cloudflare HTTP Worker | không giới hạn cứng về thời lượng; CPU time giới hạn theo gói |
| Supabase Edge Function | 150 giây wall clock ở gói Free, 400 giây ở gói trả phí, 2 giây CPU (giới hạn Supabase) |
| Vercel Function | 300 giây ở Hobby; mặc định 300 giây, tối đa 800 giây ở Pro và Enterprise (giới hạn Vercel) |
Có hai điều rút ra từ bảng. Bước nào có thể chạy lâu hơn giới hạn thì cần một monitor có thời gian chạy tối đa, vì nền tảng sẽ dừng nó trước khi nó kịp báo gì. Và giới hạn CPU tách biệt với giới hạn thời gian thực: một bước có thể bị dừng vì tính toán quá lâu dù vẫn còn xa mới hết thời lượng.
Cho cả lần chạy một trace id#
Chuẩn W3C Trace Context định nghĩa header traceparent mang trace id từ dịch vụ này sang dịch vụ kế tiếp. Nếu mọi bước đều chuyển tiếp nó, mọi lỗi của lần chạy sẽ mang cùng một id và bạn đọc được cả lần chạy như một câu chuyện liền mạch.
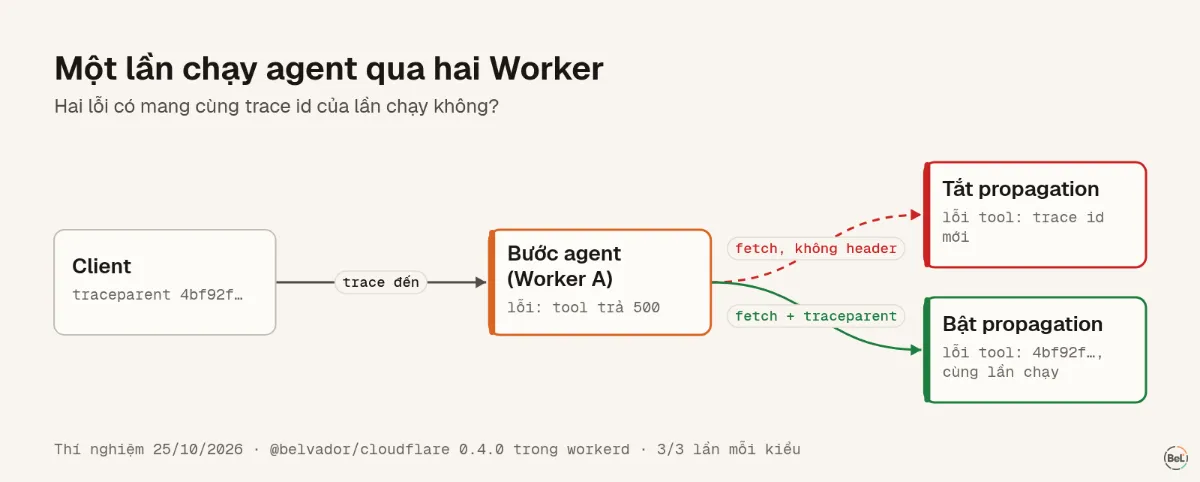
Mình thử xem việc này có tự xảy ra không. Một bước agent trong Worker thứ nhất gọi tool ở Worker thứ hai qua HTTP; tool ném lỗi, và bước agent báo lại lời gọi thất bại. Cả hai dùng cùng một SDK theo dõi lỗi. Mình chạy ba lần khi tắt trace propagation và ba lần khi bật.
| Propagation | Tool nhận được traceparent | Lỗi ở bước agent | Lỗi ở tool |
|---|---|---|---|
| Tắt | không | trace id đến từ request | một id ngẫu nhiên mới mỗi lần |
| Bật, có khai URL của tool | có | trace id đến từ request | đúng trace id đó |
Request đến vốn đã mang traceparent, và Worker đầu tiên giữ nó mà không cần cấu hình gì. Lần chạy bị đứt ở chặng thứ hai: lời gọi đi ra không mang header trace nào cho tới khi mình khai URL của tool làm propagation target. Vậy nên hãy khai mọi dịch vụ agent gọi tới, và chỉ dịch vụ của bạn thôi, vì thêm header vào API của bên thứ ba có thể làm request đó trượt kiểm tra CORS.
Bắt những lỗi không bao giờ tới handler#
Công cụ theo dõi lỗi báo những gì handler ném ra. Agent lại làm rất nhiều việc không bao giờ ném ngược về handler. Ví dụ: một lời gọi tool bọc try/catch rồi trả về câu báo lỗi lịch sự, một lần ghi log giao cho waitUntil, một promise chạy rồi bỏ đó.
Mình đã đo chuyện này trên một Cloudflare Worker thật. Một promise bị reject trong waitUntil vẫn trả 200 cho client, Cloudflare đánh dấu lần gọi là ok và chỉ liệt kê lỗi kèm theo; SDK của chính mình cũng không báo lỗi đó, cho tới khi mình sửa ở bản 0.4.1. Một promise thả nổi thì không để lại dấu vết gì.
Với agent, quy tắc rất đơn giản: mọi catch biến lỗi thành thông điệp cho model cũng phải báo lỗi đó. Gắn tag tên bước và tên tool, không kèm prompt hay tham số của tool.
Biết lúc nào một lần chạy đã dừng#
Lỗi cho bạn biết có gì đó hỏng. Lỗi không cho biết một bước chưa từng chạy, hay chạy cho tới khi bị nền tảng giết. Muốn biết điều đó, bạn cần một monitor chờ cả tín hiệu bắt đầu lẫn kết thúc.
Chi tiết phụ thuộc vào việc ping được gửi từ đâu, mình đã thử trong bài cron job chạy mãi không xong. Ping gửi từ EXIT trap bên trong job bash báo thành công cho job đã bị SIGTERM dừng, cả 3/3 lần. Ping từ dòng cron thì báo đúng mã thoát thật. Agent cũng vậy. Hãy báo lúc bắt đầu thật sớm, báo lúc kết thúc từ phần code sống lâu hơn bước đó, và để thời gian chạy tối đa bắt mọi trường hợp còn lại.
Lần chạy agent không theo lịch cố định, ví dụ mỗi request của người dùng một lần, nên dùng monitor chạy khi có sự kiện, mỗi lần chạy agent là một run. Một lịch cố định cho loại việc này lúc nào trông cũng như đang trễ. Hướng dẫn việc chạy nền nói về queue consumer, webhook và worker chạy lâu theo cùng cách đó. Khi đã có monitor, burn rate trong SLO giúp bạn chỉ bị đánh thức khi tỉ lệ lỗi thật sự đáng lo.
Một cách thiết lập đứng vững#
- Bọc mọi điểm vào: HTTP handler, queue consumer, cron handler.
- Bật trace propagation cho URL của các bước và tool của chính bạn.
- Báo mọi lỗi tự bắt có làm thay đổi bước tiếp theo của agent.
- Gắn
.catch()có báo lỗi cho mọi promise chạy nền, và cấm promise thả nổi bằng lint. - Mỗi loại lần chạy một monitor, với thời gian chạy tối đa dài hơn một chút so với lần chạy khoẻ chậm nhất.
- Không đưa prompt và tham số tool vào tag. Dùng id và mã ngắn; chỉ gửi nội dung tới nơi bạn đã quyết định là được phép. Bài gửi lỗi production cho LLM an toàn nói rõ cần lọc gì trước.
Belvador giúp ở đâu#
SDK của Belvador tiếp nối traceparent đến từ request. Khi bạn khai URL của mình, SDK chuyển tiếp nó đi, nên lỗi và các run monitor của một lần chạy agent hiện cùng nhau trên issue, ở mục Same trace. SDK chỉ nối các lỗi với nhau; nó không tạo span hay đo thời gian. Muốn có những thứ đó, hãy gửi OpenTelemetry traces. Tài liệu trace propagation liệt kê các tuỳ chọn, còn ping URL monitor dùng được với mọi ngôn ngữ. Trang Cloudflare Workers có cách cài cho Worker, và theo dõi cron dành cho các bước chạy theo lịch.
Đọc tiếp#
Trong chủ đề này
- Job thử lại, lỗi bị báo trùng: mỗi lần thử gửi gì cho công cụ theo dõi lỗi
Andrew Babo8 phút đọc
- Theo dõi lỗi Cloudflare Workers: những lỗi vẫn trả về 200
Andrew Babo7 phút đọc
- Cron job chạy mãi không xong: heartbeat thật ra nhìn thấy gì?
Andrew Babo7 phút đọc
- Ping URL cho shell job: những dòng lệnh một dòng báo sai trạng thái
Andrew Babo7 phút đọc
Bài liên quan
Mọi bài viết
Kỹ thuật
Job thử lại, lỗi bị báo trùng: mỗi lần thử gửi gì cho công cụ theo dõi lỗi
Mình cho một job thanh toán hỏng rồi thử lại bằng SDK Node của Sentry và đếm từng event. Mười job hỏng gửi 30 event, job đã hồi phục vẫn gửi 2. Dedupe không cứu được.
Andrew Babo8 phút đọc
Kỹ thuật
Theo dõi lỗi Cloudflare Workers: những lỗi vẫn trả về 200
Mình deploy một Worker hỏng theo năm kiểu khác nhau rồi xem client, Cloudflare và công cụ theo dõi lỗi mỗi bên thấy gì. Hai kiểu vẫn trả 200, và một trong hai không để lại dấu vết nào.
Andrew Babo7 phút đọc
Đọc tiếp trong tài liệu
Xem lỗi production của chính bạn như thế này
Belvador chạy trên máy chủ Hetzner của chính bạn: lỗi, cron, uptime và trace — dữ liệu vẫn là của bạn.