

Job thử lại, lỗi bị báo trùng: mỗi lần thử gửi gì cho công cụ theo dõi lỗi
Mình cho một job thanh toán hỏng rồi thử lại bằng SDK Node của Sentry và đếm từng event. Mười job hỏng gửi 30 event, job đã hồi phục vẫn gửi 2. Dedupe không cứu được.
Andrew Babo8 phút đọc
Trong bài này
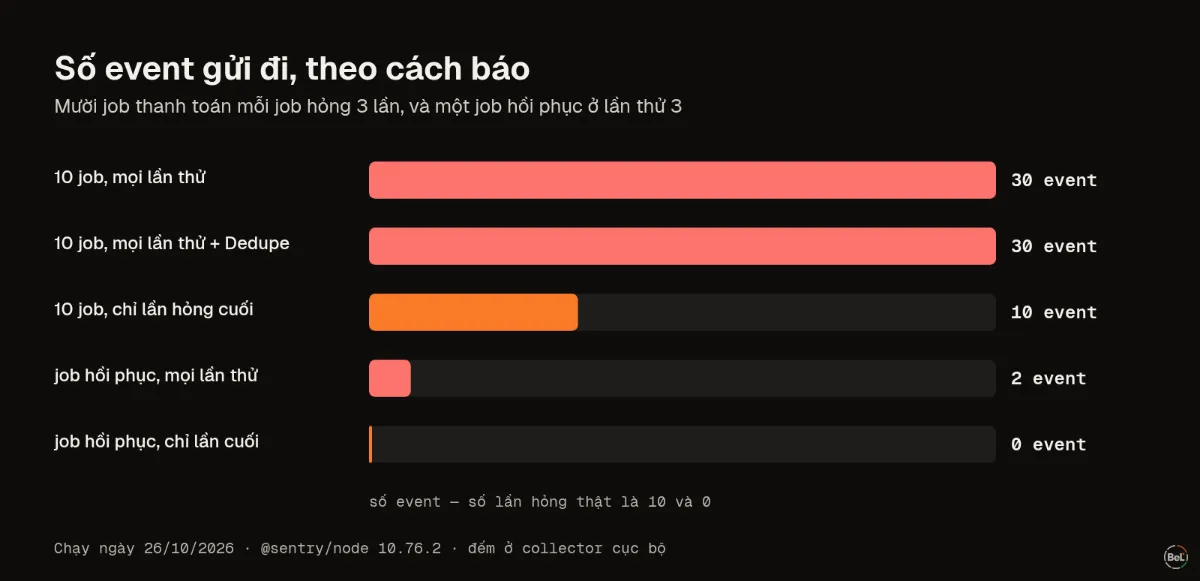
Lần thử nào bạn bắt lỗi, lần đó thành một event. Trong thí nghiệm của mình, mười job thanh toán, mỗi job hỏng ba lần, đã gửi 30 event cho 10 lần thất bại, và một job chạy được ở lần thứ ba vẫn để lại 2 event cho một việc đã xong. Công cụ gom tất cả vào một issue nên danh sách nhìn vẫn gọn.
Con số thì không: ngưỡng escalating, điều kiện "archive tới khi có thêm 100 event" và quota event đều đếm lần thử, không đếm job. Cách làm đúng là báo lần hỏng cuối, gắn số lần đã thử vào đó, còn từng lần thử thì để monitor của job ghi lại.
Thí nghiệm#
Ngày 26/10/2026, mình viết một job gọi một nhà cung cấp thanh toán giả luôn bị timeout, và một runner thử job đó ba lần, giữa các lần có nghỉ ngắn. Mỗi lần thử ném ra một Error mới, giống timeout thật. Mình chạy chín cách báo lỗi với SDK Node chính thức (@sentry/node 10.76.2) ở cấu hình mặc định, rồi chạy lại khi thêm integration Dedupe. Mỗi ca chạy trong một tiến trình Node.js 22 mới để không ca nào ảnh hưởng ca sau, và một collector cục bộ giữ lại mọi event SDK gửi đi.
Để đếm issue, mình cho từng event đi qua đúng đoạn code chuẩn hoá và gom nhóm mà node Belvador chạy khi nhận event. Mỗi ca chạy ba lần, cả ba lần ra cùng con số.
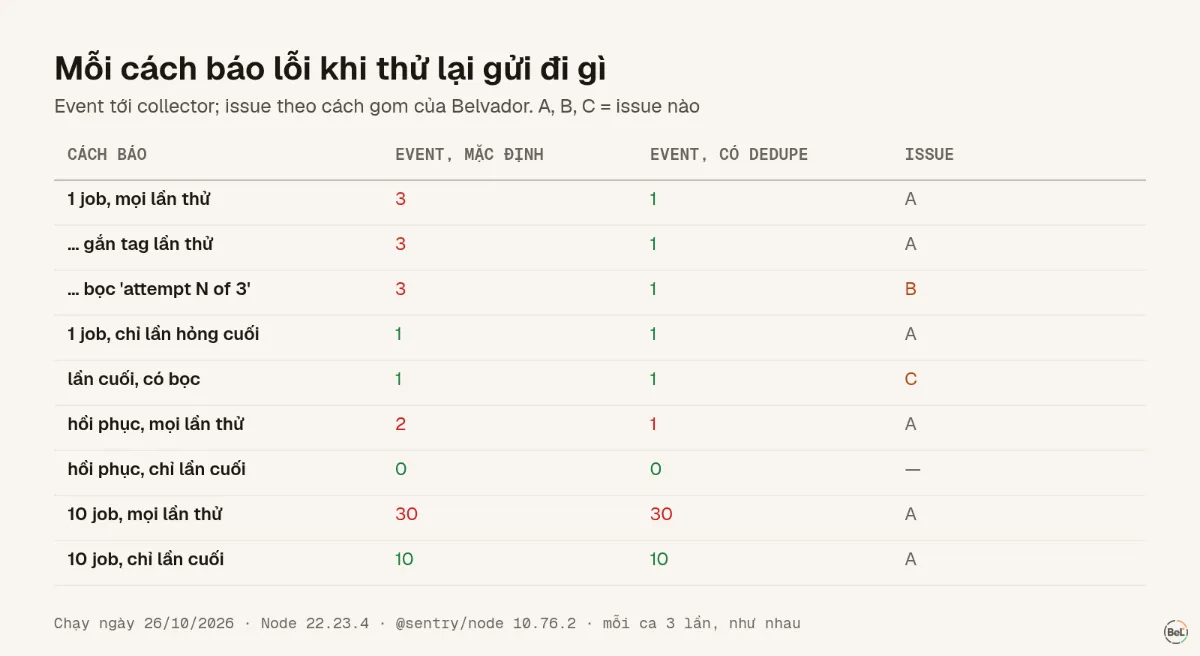
| Cách báo | Event, SDK mặc định | Event, có Dedupe | Issue |
|---|---|---|---|
| Một job hỏng 3 lần, báo mọi lần thử | 3 | 1 | 1 |
| Như trên, gắn tag số lần thử | 3 | 1 | 1 |
Như trên, bọc thành attempt N of 3 failed | 3 | 1 | 1, issue khác |
| Một job hỏng 3 lần, chỉ báo lần hỏng cuối | 1 | 1 | 1 |
Lần cuối bọc thành charge failed after 3 attempts | 1 | 1 | 1, issue khác |
| Job chạy được ở lần 3, báo mọi lần thử | 2 | 1 | 1 |
| Job chạy được ở lần 3, chỉ báo lần hỏng cuối | 0 | 0 | 0 |
| Mười job hỏng cùng lúc, báo mọi lần thử | 30 | 30 | 1 |
| Mười job hỏng cùng lúc, chỉ báo lần hỏng cuối | 10 | 10 | 1 |
Gom nhóm vẫn làm đúng việc#
Mọi lần thử của cùng một lỗi đều vào một issue, kể cả mười job có mười mã đơn khác nhau trong message. Khoá gom nhóm là stack trace, message không nằm trong đó, nên timeout for order A-1001 và timeout for order A-1010 được coi là một vấn đề. Nếu bạn sợ thử lại sẽ làm danh sách issue đầy bản sao thì không, chuyện đó không xảy ra.
Con số thì sai#
Số event của một issue là thứ các phần khác của hệ thống đọc:
- Escalating. Belvador đánh dấu issue đang tăng khi số event trong giờ qua đạt 10, hoặc gấp năm lần mức trung bình mỗi giờ nếu mức đó cao hơn. Báo ba lần thử cho mỗi job thì chỉ cần 4 job hỏng là chạm mức sàn; báo một event mỗi job thì phải 10 job.
- Điều kiện archive. "Archive tới khi có thêm 100 event" sẽ quay lại sau 34 job hỏng, không phải 100.
- Việc đã hồi phục. Job chạy được ở lần thứ ba vẫn để lại hai event lỗi. Với một hàng đợi đông và một nhà cung cấp hay chập chờn, đó là một dòng event đều đặn cho những việc đã hoàn thành.
- Quota. Event là thứ bạn trả tiền, hoặc thứ làm đầy ổ đĩa, tuỳ sản phẩm.
Dedupe không phải bộ lọc lần thử#
Ở thí nghiệm trên trình duyệt, integration Dedupe của Sentry biến 20 lần ném lỗi giống hệt thành một event, nên rất dễ nghĩ tới nó ở đây. Có hai chuyện cản đường.
Thứ nhất, SDK Node không bật nó. Danh sách integration mặc định của @sentry/node 10.76.2 không có Dedupe, còn SDK trình duyệt thì có. Trên server, mọi lần thử đều được gửi đi nếu bạn không tự thêm.
Thứ hai, thêm bằng tay thì nó chỉ cứu được trường hợp một job. Dedupe so mỗi event với event ngay trước nó, như tài liệu Sentry mô tả. Ba lần thử liên tiếp của một job thành một event. Mười job hỏng cùng lúc vẫn gửi 30: các lần thử xen kẽ nhau, mỗi lần mang một mã đơn khác, nên không event nào giống event ngay trước.
Nó còn bỏ luôn các event attempt 2 of 3 failed dù message khác nhau, vì nó so lỗi đầu tiên trong chuỗi, tức lỗi gốc bên dưới, vốn giống hệt. Đó là cái chặn quota cho vòng lặp hỏng liên tục, không phải quy tắc về lần thử nào đáng báo.
Báo lần hỏng cuối#
Runner biết lần nào là lần cuối, nên đó là chỗ đúng để quyết định:
async function runWithRetries(job, input, { attempts = 3 } = {}) { let last; for (let attempt = 1; attempt <= attempts; attempt++) { try { return await job(input); } catch (err) { last = err; if (attempt < attempts) await sleep(backoff(attempt)); } } Sentry.captureException(last, { tags: { attempts: String(attempts) } }); throw last;}Trong thí nghiệm, cách này gửi một event cho mỗi job hỏng và không gửi gì cho job đã hồi phục. Các event đó vào đúng issue cũ của các lần báo từng lần thử, nên đổi cách báo không làm đứt lịch sử issue.
Có bọc lỗi cuối hay không là lựa chọn của bạn, không phải mặc định. new Error("charge failed after 3 attempts", { cause: last }) giữ được lỗi gốc trong event, nhưng mở ra một issue mới, vì stack của nó bắt đầu ở runner chứ không phải ở chỗ gọi thanh toán. Chọn một kiểu rồi giữ nguyên: cùng một lỗi, lúc bọc lúc không, sẽ thành hai issue.
Các hệ sinh thái khác cũng đi tới cùng câu trả lời. SDK Ruby của Sentry mặc định chỉ báo lỗi Active Job khi đã hết các lần thử của retry_on, và có tuỳ chọn report_after_job_retries cho Sidekiq và Delayed Job, như trong danh sách tuỳ chọn integration và pull request đã thêm nó.
Checklist#
- Bắt lỗi ở runner, sau lần thử cuối, đừng bắt bên trong job.
- Gắn số lần thử vào event dưới dạng tag, để issue cho thấy job đã cố bao nhiêu lần.
- Giữ một kiểu: bọc hay không bọc, nhưng lần nào cũng như nhau.
- Đừng trông vào Dedupe: trên Node nó tắt, và nó không phân biệt được lần thử với job.
- Ghi lần thử ở nơi sinh ra để làm việc đó: monitor của job, vốn hiểu ba lần thử là một lượt chạy.
- Nếu vẫn muốn báo mọi lần thử, hãy đọc số event của issue là số lần thử, đừng đọc là số job hỏng.
Belvador ở đâu trong chuyện này#
withMonitor của Belvador ghi các lần thử của một lượt chạy cùng nhau khi bạn truyền runId, attempt và willRetry: lần thử còn được thử lại hiện là Sẽ thử lại và không mở sự cố. Tới hôm nay nó vẫn báo lỗi của mọi lần thử hỏng, tức đúng dòng "báo mọi lần thử" ở bảng trên. Mình phát hiện điều đó trong chính thí nghiệm này và phát hành SDK 0.5.3 ngay trong ngày: reportRetries: false chỉ gửi lần hỏng cuối thành event của issue, và lỗi mang theo số lần thử. Mặc định giữ nguyên như cũ, nên nếu bạn muốn, lượt chạy vẫn cho thấy từng lần thử gặp lỗi gì.
Issue được gom thế nào và thế nào là đang tăng có trong tài liệu issue. Hướng dẫn việc chạy nền nói nên báo ở đâu cho queue, webhook và worker chạy lâu, còn trang giám sát cron đặt các loại monitor cạnh nhau.
Đọc tiếp#
Thuộc bài hướng dẫn: Giám sát AI agent chạy trên serverless function
Bài liên quan
Mọi bài viết
Hướng dẫn
Giám sát AI agent chạy trên serverless function
Một lần chạy agent trên serverless là một chuỗi lần gọi ngắn, mỗi lần có giới hạn thời gian riêng. Bài này chỉ ra cần theo dõi gì ở từng mắt xích, kèm ba thí nghiệm nhỏ cho thấy tín hiệu bị mất ở đâu.
Andrew Babo8 phút đọc
Kỹ thuật
Theo dõi lỗi Cloudflare Workers: những lỗi vẫn trả về 200
Mình deploy một Worker hỏng theo năm kiểu khác nhau rồi xem client, Cloudflare và công cụ theo dõi lỗi mỗi bên thấy gì. Hai kiểu vẫn trả 200, và một trong hai không để lại dấu vết nào.
Andrew Babo7 phút đọc
Đọc tiếp trong tài liệu
Xem lỗi production của chính bạn như thế này
Belvador chạy trên máy chủ Hetzner của chính bạn: lỗi, cron, uptime và trace — dữ liệu vẫn là của bạn.