

Đừng báo động cho mọi exception: một ngày nhiều lỗi, bốn cách cảnh báo
Mình cho một ngày giả lập 2.268 lỗi chạy qua bốn chính sách cảnh báo. Mỗi event một cảnh báo thì gửi 2.268 tin; chính sách mà nhiều team cuối cùng chọn chỉ gửi 5 tin, và hai trong số đó vẫn là nhiễu.
Andrew Babo7 phút đọc
Trong bài này
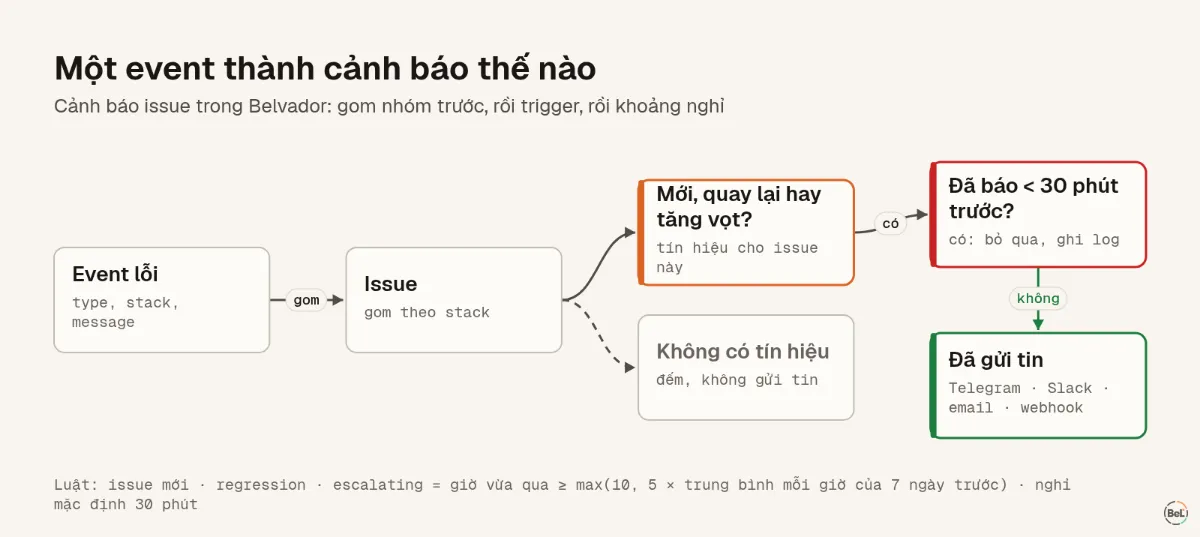
Hãy cảnh báo theo issue, đừng theo event: một issue mới, một issue đã resolve mà quay lại, và một issue cũ bỗng tăng vọt, kèm luật không nhắc lại cùng issue trong nửa giờ. Trong ngày giả lập của mình, cách đó gửi 5 cảnh báo thay vì 2.268. Hai trong năm tin vẫn là nhiễu, và không luật cảnh báo nào gỡ được chúng; chỉ có cách đừng báo những lỗi đó ngay từ đầu.
Vì sao mỗi lỗi một cảnh báo không ổn#
Sách SRE của Google đặt tiêu chuẩn trong một câu: "Every page should be actionable." Nghĩa là mỗi lần gọi người dậy phải có việc để làm. Sách cũng tả điều xảy ra khi không đạt: cảnh báo đến quá dày thì người nhận bắt đầu nghi ngờ, đọc lướt, rồi lờ luôn. Có exception không có nghĩa là phải gọi người dậy. Nó chỉ là một mẫu của vấn đề, và một bug trong nhánh code chạy liên tục có thể ném ra hàng nghìn exception trước khi có ai kịp mở laptop.
Vậy câu hỏi không phải là có nên cảnh báo lỗi hay không, mà là thay đổi nào trong lỗi của bạn đáng để làm phiền ai đó.
Ngày thử nghiệm#
Mình tạo một ngày lỗi cố định, kèm dữ liệu lịch sử của một tuần trước đó, rồi chạy nó qua bốn chính sách. Không dữ liệu nào lấy từ khách hàng; ngày này chỉ được dựng theo các kiểu lỗi mình từng gặp.
- Bot quét: 1.000 lỗi
404từ một scanner trong một giờ, thành một group mới. - Bug mới thật: user profile bị null, 800 event rải trong 16 giờ.
- Regression: một bug PDF đã sửa và resolve từ hai ngày trước quay lại với 100 event.
- Mạng chập chờn: 200 lỗi connection reset từ một dịch vụ upstream trong 10 phút.
- Issue cũ nặng thêm: timeout ở bước checkout bình thường hai lần mỗi giờ, nhảy lên 60 lần mỗi giờ trong hai giờ.
Bốn chính sách:
- A. Mỗi event một cảnh báo.
- B. Chỉ cảnh báo issue mới.
- C. Issue mới, regression và escalating, mỗi issue không nhắc lại trong 30 phút. "Escalating" dùng đúng luật của Belvador: giờ vừa qua có ít nhất
max(10, 5 × trung bình mỗi giờ của 7 ngày trước)event. - D. Chính sách C nhưng bỏ khoảng nghỉ 30 phút.
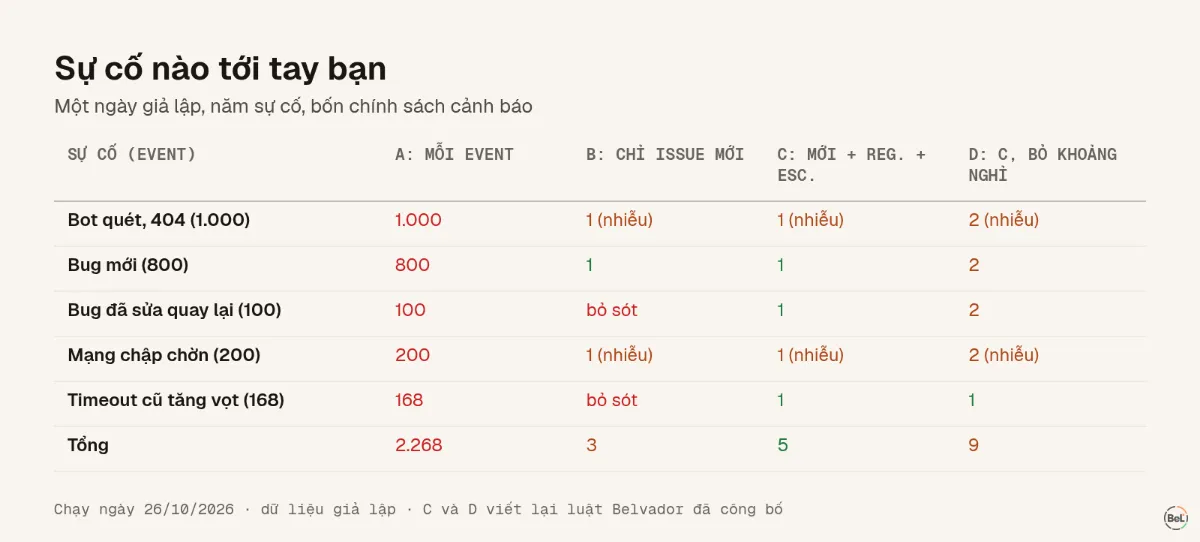
| Chính sách | Số cảnh báo | Bỏ sót |
|---|---|---|
| A: mỗi event | 2.268 | không sót gì, nhưng không ai đọc |
| B: chỉ issue mới | 3 | regression và đợt tăng timeout ở checkout |
| C: mới + regression + escalating, 30 phút | 5 | không sót gì |
| D: C bỏ khoảng nghỉ | 9 | không sót gì, nhưng 4 tin trùng |
Ngày đó cho thấy gì#
Grouping gánh gần hết việc#
Biến 2.268 event thành 5 issue là chỗ gần như toàn bộ nhiễu biến mất. Nhưng điều đó chỉ đúng khi grouping đúng. Nếu một giá trị thay đổi theo từng request lọt vào message lỗi, mỗi event có thể thành một issue "mới" và bạn quay về chính sách A. Lỗi có type và stack ổn định thì gom tốt; lỗi có id, URL hay timestamp trong message thì cần sửa message cho cố định hoặc đặt fingerprint riêng.
"Chỉ issue mới" thì yên tĩnh nhưng mù một nửa#
Chính sách B nhìn rất hấp dẫn: ba tin một ngày. Nhưng nó im lặng khi một bug bạn đã sửa quay lại, và cũng im lặng khi timeout quen thuộc nhảy từ hai lần mỗi giờ lên gần một lần mỗi phút. Đó thường là hai chuyện gấp nhất trong ngày, vì người dùng đã gặp chúng rồi.
Khoảng nghỉ 30 phút gỡ được cảnh báo đôi#
Bỏ khoảng nghỉ, chính sách D gửi thêm bốn tin, và cả bốn giống nhau: báo issue mới, vài phút sau lại báo "escalating" cho chính issue đó, vì một issue vừa xuất hiện với nhiều event thì cũng đang tăng nhanh. Khoảng nghỉ tính theo thời điểm lỗi xảy ra và theo từng issue, nên nó chặn đúng mấy tin trùng đó và không chặn gì khác.
Hai trong năm cảnh báo vẫn là nhiễu#
Đợt bot quét và đợt mạng chập chờn đều được báo như issue mới. Cả grouping lẫn trigger đều không phân biệt được bot gõ vào URL cũ với một bug thật: cả hai đều là group mới có nhiều event. Phải xử lý trước khi lỗi được báo đi:
- Đừng capture thứ không phải bug. Lỗi
404cho URL chưa từng tồn tại, request mà client đã huỷ, lỗi validation người dùng tự sửa được: hãy xử lý chúng, ghi log nếu muốn, nhưng đừng gửi như error. - Dùng level. Báo các lỗi đã lường trước và tự hồi phục được ở mức warning, rồi đặt level tối thiểu của luật là error.
- Lọc theo environment. Cảnh báo từ bản deploy preview lúc 3 giờ sáng sẽ dạy cả team lờ kênh cảnh báo.
- Archive những gì bạn đã quyết định chung sống. Archive kiểu "cho tới khi escalating" giữ cho một lỗi chập chờn quen thuộc im lặng, cho tới khi nó không còn là chập chờn nữa.
Khi nào nên dùng thứ khác ngoài cảnh báo issue#
Cảnh báo issue trả lời câu "có gì mới hỏng hoặc hỏng nặng hơn không?". Nó không trả lời câu "người dùng có đang khổ không?". Câu đó cần cảnh báo theo SLO: cảnh báo burn rate kêu khi error budget bị tiêu nhanh, bất kể issue nào đang tiêu nó. Mình đã chạy lại bốn sự cố qua một bộ như thế trong bài burn rate trong SLO, giải thích qua bốn sự cố; tỷ lệ lỗi 1 % kéo dài mà không bao giờ tạo issue mới chính là thứ nó bắt được.
Còn với những lỗi bị code nuốt mất trước khi cảnh báo nào kịp thấy, bài lỗi JavaScript thoát ra từ đâu trong ứng dụng do AI viết đi qua từng chỗ chúng hay trốn.
Belvador giúp ở đâu#
Luật cảnh báo của Belvador kêu khi có issue mới, regression và escalating, kèm level tối thiểu, environment, project và khoảng Không lặp lại trong mặc định 30 phút. Tin nhắn đi tới bot Telegram, Slack webhook, tài khoản email hoặc webhook có chữ ký của chính bạn. Belvador không tự đoán lỗi nào là nhiễu: việc không capture lỗi 404 của bot vẫn nằm ở code của bạn. Tài liệu cảnh báo nói về luật và nơi nhận, tài liệu issue nói về resolve, regression và archive, còn trang cảnh báo cho thấy phần này đứng cạnh monitor, uptime check và SLO thế nào.
Đọc tiếp#
- Observability cho team nhỏ, bài hướng dẫn chính mà bài này thuộc về.
- Burn rate trong SLO, giải thích qua bốn sự cố, khi bạn cần cảnh báo theo trải nghiệm người dùng thay vì theo issue.
- Lỗi JavaScript thoát ra từ đâu, để lỗi thật không bị nuốt trước khi tới luật cảnh báo.
Thuộc bài hướng dẫn: Observability cho team nhỏ: năm tín hiệu, theo đúng thứ tự cần dùng
Bài liên quan
Mọi bài viết
Hướng dẫn
Observability cho team nhỏ: năm tín hiệu, theo đúng thứ tự cần dùng
Team hai người chưa cần cả một nền tảng metrics. Cái cần là biết khi người dùng gặp lỗi, khi một job ngừng chạy, khi trang web sập, và sau này là khi người dùng có một tuần tệ.
Andrew Babo7 phút đọc
Kỹ thuật
Burn rate trong SLO, giải thích dễ hiểu qua bốn sự cố
Mình cho bốn sự cố giả lập chạy qua đúng bộ đánh giá SLO mà Belvador chạy mỗi phút. Trên cùng lưu lượng, cảnh báo theo ngưỡng kêu 16 lần chỉ vì một lỗi rò rỉ chậm.
Andrew Babo7 phút đọc
Đọc tiếp trong tài liệu
Xem lỗi production của chính bạn như thế này
Belvador chạy trên máy chủ Hetzner của chính bạn: lỗi, cron, uptime và trace — dữ liệu vẫn là của bạn.