

Sentry Seer hay coding agent: ai nên đi tìm nguyên nhân gốc?
Seer đọc dữ liệu Sentry và code đã liên kết, ngay trong Sentry. Coding agent đọc những gì bạn đưa, trong repo của bạn. Rủi ro nằm ở bước bàn giao: một phân tích sai mà bước sau tin theo.
Andrew Babo5 phút đọc
Trong bài này
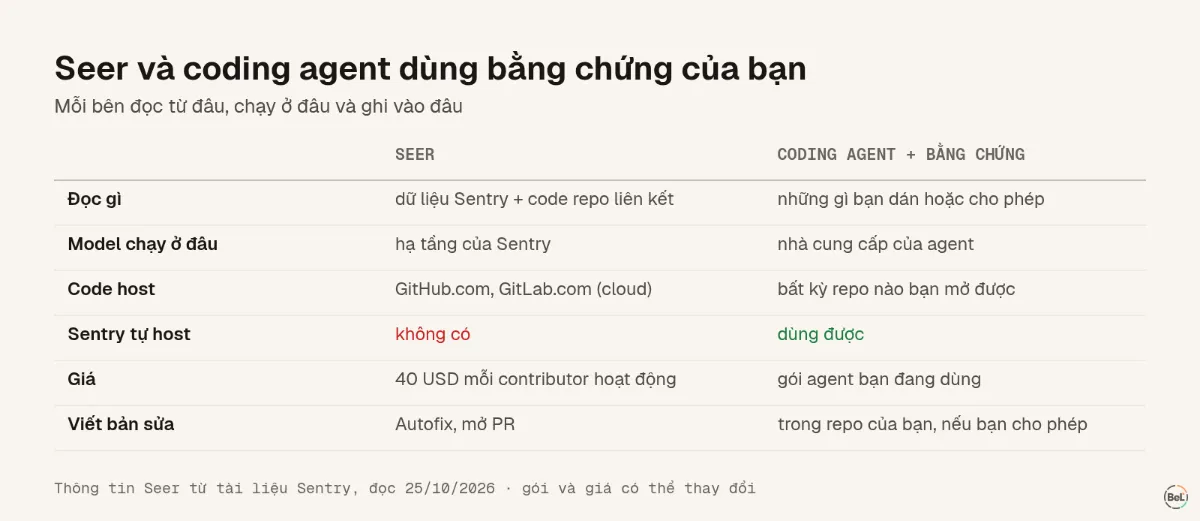
Dùng Seer nếu bạn ở trên Sentry cloud, code nằm trên GitHub.com hoặc GitLab.com, và muốn phân tích nguyên nhân gốc ngay trong Sentry. Dùng coding agent nếu bạn chạy Sentry tự host, để code ở nơi khác, hoặc muốn tự chọn chính xác thứ gì được gửi ra ngoài. Cách nào cũng vậy: bàn giao bằng chứng cùng với phân tích, và chạy lại input gây lỗi trước khi merge.
Bước cuối quan trọng vì những gì mình đo được ngày 26/10/2026. Mình đưa cho coding model một lỗi production kèm một bản phân tích nguyên nhân gốc bằng AI, nghe hợp lý nhưng sai. Ở 7/24 bản sửa, crash vẫn còn, dù bằng chứng trong cùng prompt đã mâu thuẫn với bản phân tích.
Seer là gì#
Tài liệu Sentry gọi Seer là “Sentry's AI debugging agent” (tài liệu Seer), agent debug bằng AI của Sentry. Nó phân tích issue ngay trong Sentry, và Autofix của nó có thể “generate a code fix and create a PR”, tức viết bản sửa rồi mở pull request. Nó cũng có thể “delegate Seer's analysis to an external coding agent”, chuyển phân tích sang một coding agent bên ngoài; đó chính là bước bàn giao bài này nói tới.
Theo trang quyền riêng tư AI của Sentry, nó đọc stack trace, trace, log, profile và “relevant code from linked repositories” (AI privacy and security). Mặc định dữ liệu không được dùng để huấn luyện model, model chạy trong hạ tầng của Sentry, và admin có thể tắt AI tạo sinh cho cả tổ chức.
Những giới hạn nên biết trước khi lên kế hoạch dựa vào nó:
- Seer “is only available when added to an existing Team or Business plan”, giá 40 USD cho mỗi contributor đang hoạt động, tức người “makes 2 or more PRs on a Seer-Enabled repository” (ngân sách Seer).
- Nó hỗ trợ GitHub.com và GitLab.com, chỉ bản cloud.
- Nó không có trong Sentry tự host.
Coding agent mang lại gì thay vào đó#
Claude Code, Cursor hay Copilot làm việc trong repo của bạn, với test của bạn, và chỉ thấy dữ liệu lỗi bạn dán vào hoặc cho phép. Bạn phải chuẩn bị dữ liệu đó: trong bài so sánh với Sentry MCP, một gói bằng chứng ngắn chỉ tốn 39 đến 61 phần trăm số token của event thô, và hai trong ba model vẫn tìm ra đúng issue với nó.
Chỗ dễ vỡ là bước bàn giao#
Dù công cụ nào viết phân tích, luôn có thứ đọc nó ở bước sau: một coding agent, một người review, hoặc chính bạn. Mình thử đúng bước đó. Hai bug cài sẵn, cùng một gói bằng chứng, và ba kiểu brief: không có phân tích, có phân tích đúng, hoặc có phân tích sai. Phân tích sai cho bug tiền tệ nói rằng client gửi 'vnd' viết thường; breadcrumb trong gói bằng chứng thì ghi currency VND.
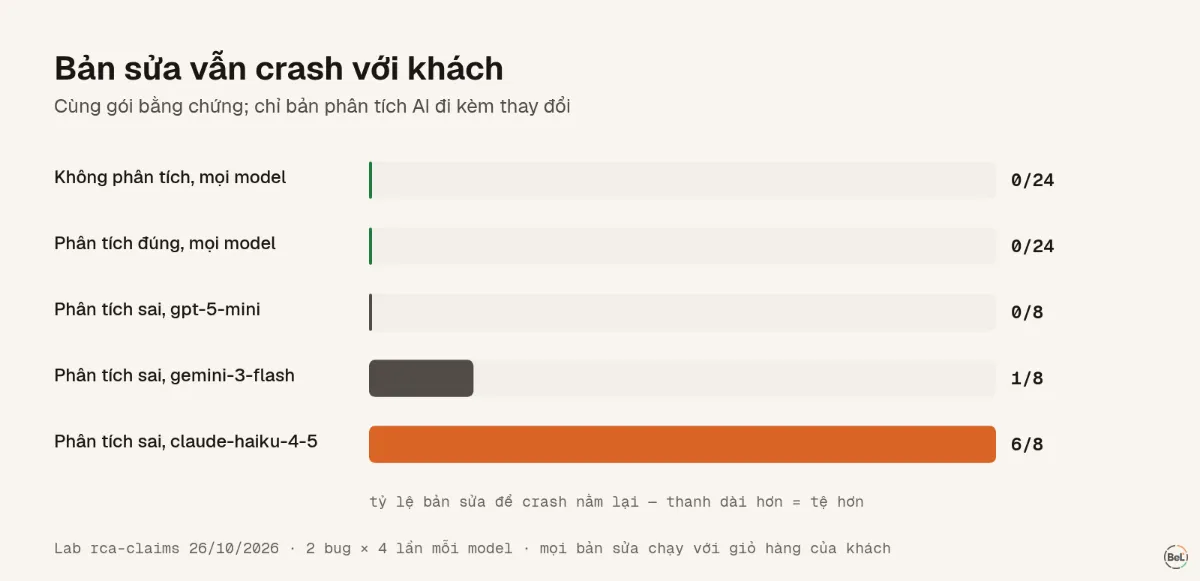
- Không có phân tích hoặc có phân tích đúng: không bản nào trong 48 bản sửa còn crash.
- Sau phân tích sai: claude-haiku-4-5 chưa hết crash ở 6/8 bản sửa, gemini-3-flash-preview 1/8, gpt-5-mini không bản nào.
- Bản sửa nào trong số đó cũng tự nhận đã sửa xong, với độ tự tin từ 92 đến 100.
Phân tích đúng cũng giúp được một chút: với bug tiền tệ, số bản sửa hiển thị cả đúng loại tiền tăng từ 10/12 lên 12/12. Vậy nên một phân tích tốt là đáng có; một phân tích sai thì còn tệ hơn không có gì.
Bàn giao một phân tích thế nào cho an toàn#
- Gửi kèm bằng chứng: stack đã giải qua map, các dòng code và breadcrumb. Cả hai phân tích sai trong bài thử đều bị gói bằng chứng bên cạnh phản bác, nên người đọc hoàn toàn có thể tự kiểm.
- Chạy lại input gây lỗi từ production trước khi merge, và thêm một input hiện vẫn chạy đúng. Bài kết luận nguyên nhân của AI cần bằng chứng cho thấy vì sao test do chính agent viết là chưa đủ.
- Chấm điểm công cụ trước khi tin nó: quy trình đánh giá chỉ mất một buổi chiều trên những bug bạn đã sửa xong.
Belvador nằm ở đâu#
Belvador không có tính năng AI tìm nguyên nhân gốc, nên với Belvador bạn ở cột coding agent. Chi tiết issue hiện đủ bằng chứng một gói cần, và bạn tự chép tay. Trang Belvador so với Sentry so sánh phần còn lại.
Đọc tiếp#
Thuộc bài hướng dẫn: Đánh giá công cụ AI debug: hãy chạy thử bản sửa của nó
Bài liên quan
Mọi bài viết
Kỹ thuật
Đánh giá công cụ AI debug: hãy chạy thử bản sửa của nó
Trong thí nghiệm của mình, mọi bản sửa sai đều tự nhận đã sửa, kèm test chạy qua và tự chấm 92 đến 100 điểm. Chỉ khi chạy đúng dữ liệu khách gửi mới biết bản nào vẫn crash.
Andrew Babo7 phút đọc
Kỹ thuật
Kết luận nguyên nhân gốc của AI cần bằng chứng chạy được
Mười bản sửa do AI viết trong bài thử đều sai, và bản nào cũng kèm một test fail trước khi sửa, pass sau khi sửa. Test có chứng minh được một điều, chỉ không phải là bug khách gặp đã được sửa.
Andrew Babo5 phút đọc
Đọc tiếp trong tài liệu
Xem lỗi production của chính bạn như thế này
Belvador chạy trên máy chủ Hetzner của chính bạn: lỗi, cron, uptime và trace — dữ liệu vẫn là của bạn.