

Lưu trữ dữ liệu lỗi và nơi nhà cung cấp AI xử lý: hai lựa chọn riêng
Giữ dữ liệu lỗi ở EU không nói gì về nơi một model AI xử lý cái lỗi bạn dán vào. Mình so cài đặt của bốn nhà cung cấp AI và thấy nơi lưu và nơi xử lý là hai nút vặn khác nhau.
Andrew Babo6 phút đọc
Trong bài này
Nơi công cụ theo dõi lỗi lưu dữ liệu và nơi một model AI xử lý dữ liệu đó là hai lựa chọn riêng. Chọn EU cho cái đầu không giúp gì cho cái sau. Phần lớn nhà cung cấp AI còn tách cài đặt của chính họ làm hai: dữ liệu được lưu ở đâu, và request được xử lý ở đâu.
Vì vậy trước khi lỗi từ một ứng dụng ở EU hay Việt Nam được gửi tới công cụ AI, hãy kiểm cả hai nút vặn cho đúng nhà cung cấp và đúng model đó. Mình đọc tài liệu của bốn nhà cung cấp lớn nhất ngày 25/10/2026 và tóm lại những gì mỗi bên cho chọn.
Một lỗi, hai nơi#
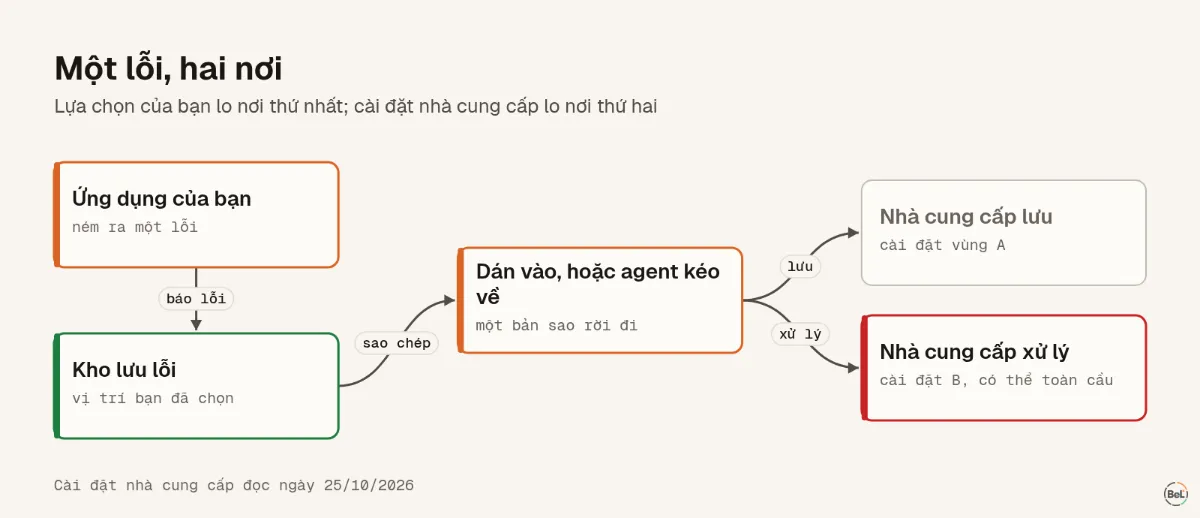
Một lỗi bắt đầu trong ứng dụng và nằm lại trong kho lưu lỗi. Bạn đã chọn vị trí đó, thường là có lý do: một hợp đồng, câu hỏi của khách hàng, một điều luật. Khi ai đó dán lỗi vào khung chat, hay một coding agent tự kéo nó về, một bản sao sẽ tới nhà cung cấp AI. Bản sao đó theo luật của nhà cung cấp, không theo luật của kho lưu lỗi.
Bốn nhà cung cấp cho chọn gì#
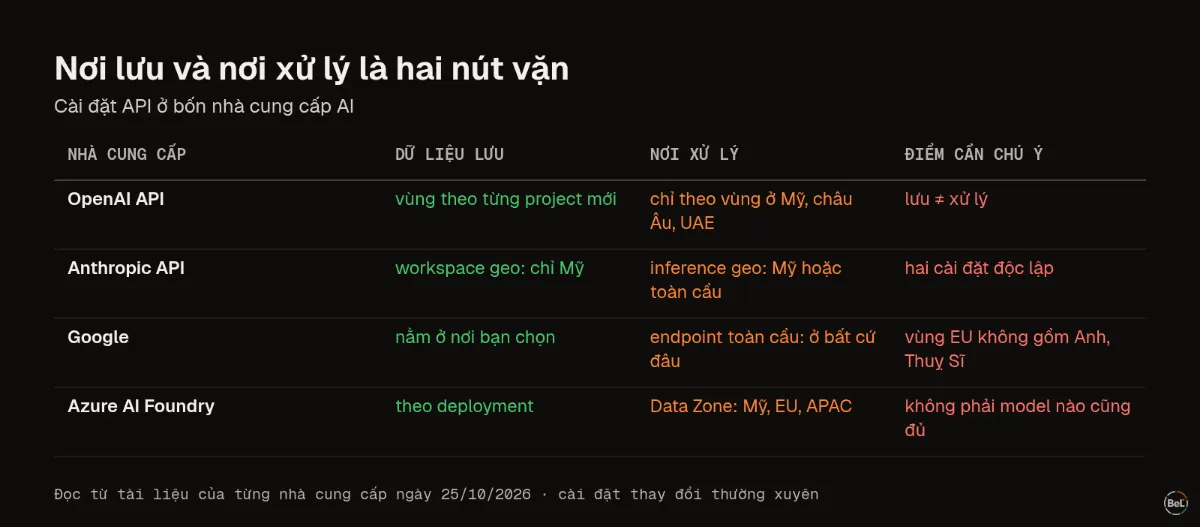
| Nhà cung cấp | Dữ liệu lưu có thể nằm ở đâu | Request được xử lý ở đâu | Điểm cần chú ý |
|---|---|---|---|
| OpenAI API | Một vùng chọn cho từng project mới: Mỹ, châu Âu và vài nơi khác | Chỉ xử lý theo vùng ở Mỹ, châu Âu và UAE | Nơi lưu và nơi xử lý tách riêng; một số dữ liệu nằm ngoài cài đặt |
| Anthropic API | Workspace geo: chỉ Mỹ | Inference geo: Mỹ hoặc toàn cầu | Hai cài đặt độc lập |
| Google (Gemini Enterprise Agent Platform) | Dữ liệu lưu nằm yên ở vị trí bạn chọn | Endpoint toàn cầu có thể xử lý ở bất cứ đâu; endpoint đa vùng ở trong khu vực của nó | Vùng đa EU không gồm Anh và Thuỵ Sĩ |
| Azure AI Foundry | Theo từng deployment | Data Zone: Mỹ, EU hoặc APAC | Không phải model nào cũng hỗ trợ mọi kiểu deployment |
Có ba chi tiết dễ bị bỏ qua.
Nơi lưu không phải nơi xử lý#
OpenAI nói thẳng: “Support for regional storage does not imply support for regional processing.” Họ cũng lưu ý rằng có thể “process and temporarily store Customer Content outside of the Region to deliver the services”, tức xử lý và lưu tạm nội dung ngoài vùng đã chọn để cung cấp dịch vụ.
“Toàn cầu” nghĩa là ở bất cứ đâu#
Tài liệu của Google viết rằng request gửi tới endpoint toàn cầu “may be processed in any Google Cloud location around the world”. Anthropic có hai cài đặt, inference geo và workspace geo, và “Two independent settings govern this”.
Còn tuỳ vào model#
Microsoft ghi chú “Not all models support all deployment types.” Phần data residency của OpenAI chỉ áp dụng cho các endpoint, model và snapshot được liệt kê. Một model mới hơn có thể chưa có tuỳ chọn bạn đang dựa vào.
Vì sao luật quan tâm tới bản sao thứ hai#
Đây không phải tư vấn pháp lý, chỉ là những phần trong quy định khiến bản sao thứ hai trở nên quan trọng.
- Việt Nam. Nghị định 13/2023/NĐ-CP ngày 17/4/2023 đã yêu cầu “lập Hồ sơ đánh giá tác động chuyển dữ liệu cá nhân ra nước ngoài”. Luật Bảo vệ dữ liệu cá nhân số 91/2025/QH15, ban hành ngày 26/6/2025, có hiệu lực từ 01/01/2026. Theo bản luật được đăng lại, bên chuyển dữ liệu cá nhân xuyên biên giới phải lập hồ sơ đánh giá tác động trong 60 ngày kể từ lần chuyển đầu tiên, và phạm vi gồm cả việc dùng nền tảng ở nước ngoài.
- EU. Chương V của GDPR, Điều 44 tới 46, điều chỉnh việc chuyển dữ liệu cá nhân ra ngoài EU. Khung bảo vệ dữ liệu EU–Mỹ chỉ áp dụng cho “companies in the United States that participate in the Data Privacy Framework”, tức các công ty Mỹ có tham gia, không phải mọi bên nhận ở Mỹ.
Một lỗi có chứa email, tên hay địa chỉ IP là dữ liệu cá nhân. Dán nó vào một công cụ AI đặt ở nước khác có thể là một lần chuyển dữ liệu ra nước ngoài.
Kho lưu lỗi có thể nằm ở đâu#
Mình đọc danh sách vị trí của Hetzner ngày 26/10/2026: sáu vị trí, ba ở EU (Falkenstein và Nuremberg ở Đức, Helsinki ở Phần Lan), hai ở Mỹ và một ở Singapore. Belvador tạo node của mỗi khách hàng ở một trong ba vị trí EU, trong chính dự án Hetzner của khách hàng. Nút vặn thứ nhất coi như xong. Nút thứ hai vẫn là của bạn.
Danh sách kiểm trước khi gửi lỗi cho công cụ AI#
- Ghi lại dữ liệu lỗi đang được lưu ở đâu, và vì sao chọn nơi đó.
- Với từng công cụ AI team đang dùng, tìm cả hai cài đặt: dữ liệu lưu ở đâu và request được xử lý ở đâu. Ghi lại ngày bạn đọc.
- Kiểm tra model bạn thật sự gọi có hỗ trợ các cài đặt đó không.
- Xoá dữ liệu cá nhân trước khi gửi, để phần lớn lỗi không còn chứa gì. Bài lọc PII trong error monitoring cho thấy luật tự động bỏ sót những gì.
- Nếu team nhỏ và thấy quy định nặng nề, bài observability cho team nhỏ giúp bạn quyết định nên thu thập gì ngay từ đầu.
Belvador giúp ở đâu#
Belvador lưu dữ liệu lỗi trên một node trong chính dự án Hetzner của bạn, ở Đức hoặc Phần Lan, và không gửi chút dữ liệu nào cho nhà cung cấp AI. Trang bảo vệ dữ liệu chỉ ra từng nơi dữ liệu của bạn đi qua, còn trang kết nối node cho thấy node được tạo thế nào. Trang BYOC trên Hetzner và trang xử lý dữ liệu giải thích bên nào giữ cái gì.
Đọc tiếp#
Thuộc bài hướng dẫn: Gửi lỗi production cho LLM thế nào cho an toàn
Bài liên quan
Mọi bài viết
Hướng dẫn
Gửi lỗi production cho LLM thế nào cho an toàn
Một event lỗi chứa secret, dữ liệu cá nhân và chữ người dùng gõ vào. Mình gửi một event có lệnh ẩn cho bốn model 72 lần; dán nguyên văn, một model làm theo cả sáu lần và có lần khuyên tắt xác thực.
Andrew Babo8 phút đọc
Kỹ thuật
Lọc PII trong error monitoring mà không mất ngữ cảnh
Mình chạy bộ lọc của Belvador trên 16 mẫu lỗi giả lập, sửa ba lỗ hổng là lỗi của chính mình rồi chạy lại. Secret có hình dạng quen thuộc đều bị xoá; số điện thoại và tên người vẫn lọt.
Andrew Babo7 phút đọc
Đọc tiếp trong tài liệu
Xem lỗi production của chính bạn như thế này
Belvador chạy trên máy chủ Hetzner của chính bạn: lỗi, cron, uptime và trace — dữ liệu vẫn là của bạn.