

Observability cho team nhỏ: năm tín hiệu, theo đúng thứ tự cần dùng
Team hai người chưa cần cả một nền tảng metrics. Cái cần là biết khi người dùng gặp lỗi, khi một job ngừng chạy, khi trang web sập, và sau này là khi người dùng có một tuần tệ.
Andrew Babo7 phút đọc
Trong bài này
Hãy thêm tín hiệu theo thứ tự mức độ đau: lỗi trước, rồi monitor cho mọi job định kỳ, rồi uptime check từ bên ngoài. Khi đã có lưu lượng thật, thêm một SLO trên luồng chính. Chỉ thêm trace khi một request bắt đầu đi qua nhiều dịch vụ, đừng thêm sớm hơn.
Thứ tự đó đến từ một câu hỏi đơn giản: người dùng sẽ nhận ra chuyện gì trước bạn? Với team nhỏ, câu trả lời thật lòng là "gần như mọi thứ", nên các tín hiệu đầu tiên phải lấp được khoảng trống lớn nhất với ít thời gian cài đặt nhất.
Bốn câu hỏi team nhỏ cần trả lời được#
Sách SRE của Google gọi tên bốn tín hiệu vàng cho một hệ thống phục vụ người dùng: "latency, traffic, errors, and saturation", tức độ trễ, lưu lượng, lỗi và mức bão hoà. Chúng là lăng kính đúng cho một dịch vụ lớn có dashboard và lịch trực. Team hai người cần thứ thẳng thắn hơn, vì chẳng ai ngồi nhìn dashboard cả:
- Người dùng có đang gặp lỗi không, và có lỗi nào mới không?
- Các job đáng lẽ phải chạy thì có chạy thật không?
- Trang web còn truy cập được không?
- Người dùng có đang trải qua một tuần tệ hơn mức mình đã hứa không?
Độ trễ và mức bão hoà cũng quan trọng, nhưng thường lộ ra ở một trong bốn câu trên trước: thành lỗi timeout trong danh sách lỗi, thành một job chạy quá giới hạn, hoặc thành một SLO bắt đầu tiêu budget.
Tín hiệu nào thấy kiểu hỏng nào#
Mình đã chạy bốn thí nghiệm nhỏ cho nhóm bài này. Gộp lại, chúng cho thấy không có tín hiệu nào phủ hết mọi thứ, và tín hiệu nào phủ phần nào.
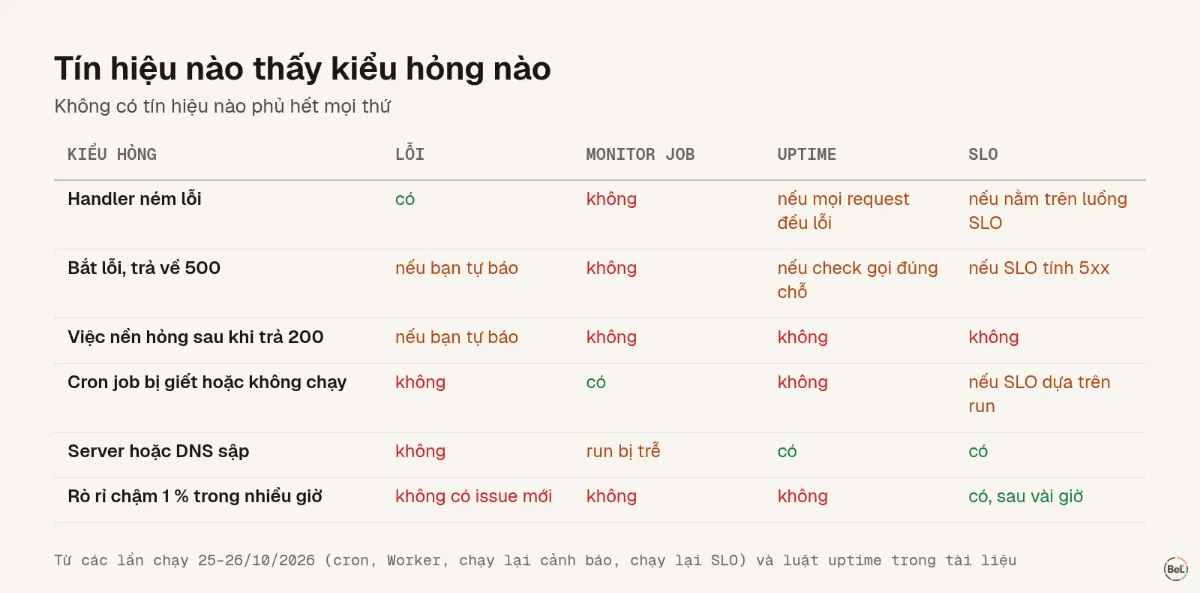
| Kiểu hỏng | Theo dõi lỗi | Monitor job | Uptime check | SLO |
|---|---|---|---|---|
| Handler ném lỗi | có | không | chỉ khi mọi request đều lỗi | có, nếu nằm trên luồng SLO |
| Bắt lỗi rồi trả về 500 | chỉ khi bạn tự báo | không | chỉ khi check gọi đúng chỗ đó | nếu SLO tính response 5xx |
| Việc chạy nền hỏng sau khi đã trả 200 | chỉ khi bạn tự báo | không | không | không |
| Cron job bị giết hoặc không chạy | không | có | không | nếu SLO dựa trên các run của job |
| Cả server hoặc DNS sập | không, chẳng có gì chạy | các run bị trễ sẽ hiện ra | có | có |
| Rò rỉ chậm 1 % trong nhiều giờ | có event, nhưng không có issue mới | không | không | có, sau vài giờ |
Có ba điều nổi bật.
Theo dõi lỗi chỉ thấy những gì được báo#
Trong thí nghiệm Cloudflare Worker, lỗi bị bắt rồi trả về 500 và promise chạy nền bị lỗi đều vô hình với công cụ theo dõi lỗi. Cách sửa nằm trong code của bạn: báo những gì bạn bắt được. Bài giám sát agent chạy trên serverless chỉ ra những lỗi đó trốn ở đâu.
Sự im lặng cần một tín hiệu riêng#
Cron job bị giết hoặc không hề chạy thì chẳng tạo ra lỗi nào. Chỉ có thứ gì đó chờ một tín hiệu ping và nhận ra khi nó không tới mới bắt được. Bài cron job chạy mãi không xong cho thấy gửi ping từ đâu thì đáng tin.
Vấn đề chậm cần một budget#
Tỉ lệ lỗi đều đều 1 % không bao giờ tạo issue mới, nên cảnh báo issue cứ im. Trong lần chạy lại, cảnh báo burn rate SLO bắt được nó sau 3 giờ 37 phút, chỉ một cảnh báo thay vì 16 cảnh báo của luật ngưỡng. Chi tiết nằm ở bài burn rate trong SLO.
Thứ tự nên thêm#
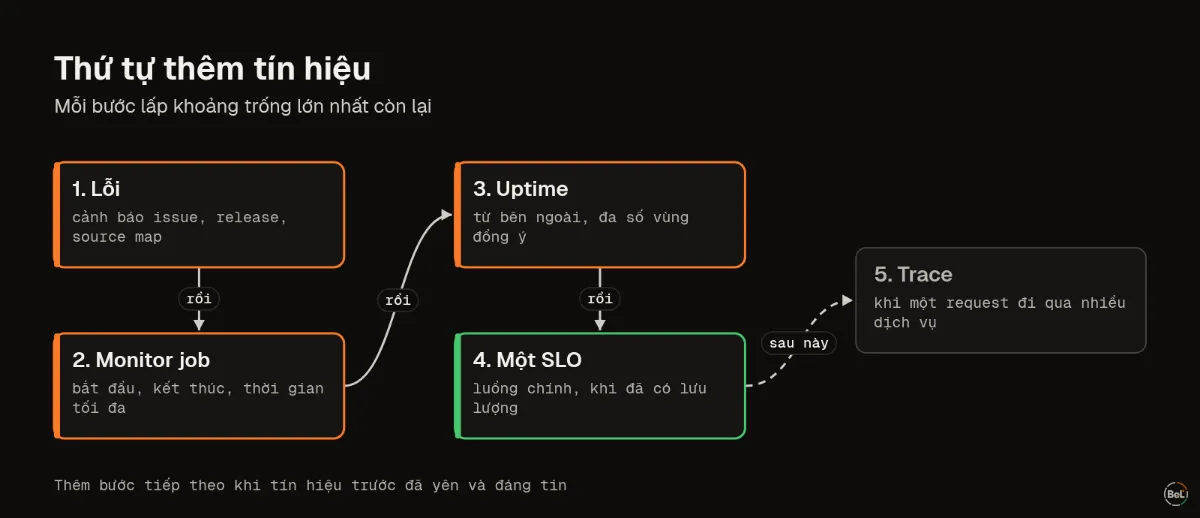
1. Lỗi, kèm cảnh báo theo issue#
Cài SDK theo dõi lỗi ở cả trình duyệt lẫn server, đặt release để biết lần deploy nào làm hỏng, và cảnh báo khi có issue mới, issue quay lại hoặc issue tăng đột biến. Trong ngày giả lập nhiều nhiễu của mình, chính sách đó gửi 5 cảnh báo, trong khi kiểu một cảnh báo cho mỗi event gửi 2.268. Bật source map để stack trace trỏ vào code của bạn, không phải vào file đã minify.
2. Monitor cho mọi job định kỳ#
Backup, chạy hoá đơn, đồng bộ dữ liệu, vòng lặp agent theo giờ: mỗi việc một monitor chờ cả tín hiệu bắt đầu lẫn kết thúc. Gửi ping cuối từ bên ngoài job, và đặt thời gian chạy tối đa, để job bị giết vẫn kịp báo động.
3. Uptime check từ bên ngoài#
Theo dõi lỗi chạy bên trong ứng dụng. Khi ứng dụng, server, DNS hay chứng chỉ của nó không còn, nó chẳng báo được gì. Uptime check hỏi từ bên ngoài, từ nhiều vùng, và chỉ nên mở sự cố khi đa số vùng đồng ý, để một đường mạng xấu không gọi bạn dậy lúc nửa đêm.
4. Một SLO, khi đã có lưu lượng#
Chọn luồng người dùng quan tâm nhất, như đăng nhập hay thanh toán, và đặt mục tiêu availability bạn thật sự đạt được: 99,5 % hoặc 99,9 %, đừng đặt 99,99 %. Khi lưu lượng còn quá ít, con số sẽ nhảy lung tung; hãy chờ tới lúc một phút tệ chỉ là phần nhỏ của một giờ.
5. Trace, khi một request đi qua nhiều dịch vụ#
OpenTelemetry mô tả ba tín hiệu chính: trace, metric và log. Trace đáng công khi một cú nhấp chuột đi qua frontend, API, queue rồi worker, và bạn không biết chỗ nào chậm. Trước lúc đó, một trace id dùng chung trên các lỗi là đủ để nối chúng lại. Khi đã thêm trace, hãy quyết định cách sampling ngay từ đầu, vì giữ lại mọi span sẽ tốn kém rất nhanh.
Những gì chưa cần làm#
- Dashboard không ai mở. Cảnh báo cộng với mỗi tuần xem lại danh sách issue giúp team nhỏ nhiều hơn.
- Metric cho mọi thứ. Bắt đầu với vài con số có thể làm bạn đổi quyết định.
- Gọi người dậy vì warning. Gửi warning vào một kênh bạn đọc buổi sáng, hoặc đừng gửi luôn.
- Ghi log toàn bộ body của request. Đó là rủi ro quyền riêng tư, và hiếm khi là thứ bạn cần khi có sự cố.
Belvador giúp ở đâu#
Belvador lo bốn bước đầu ở cùng một chỗ: theo dõi lỗi kèm cảnh báo issue, monitor và ping URL cho job, uptime check từ nhiều vùng, và SLO kèm cảnh báo burn rate. Với bước 5, Belvador nhận trace và log OpenTelemetry. Dữ liệu lỗi được lưu trên một server trong chính tài khoản Hetzner của bạn, do Belvador cài đặt và bảo trì. Phần tổng quan giải thích các phần nối với nhau thế nào, hướng dẫn nhanh uptime và tài liệu ping URL lo bước 2 và 3, còn SLO lo bước 4. Trang cảnh báo và trang theo dõi uptime cho thấy cảnh báo tới tay bạn ra sao.
Đọc tiếp#
Trong chủ đề này
- Burn rate trong SLO, giải thích dễ hiểu qua bốn sự cố
Andrew Babo7 phút đọc
- Đừng báo động cho mọi exception: một ngày nhiều lỗi, bốn cách cảnh báo
Andrew Babo7 phút đọc
Bài liên quan
Mọi bài viết
Kỹ thuật
Burn rate trong SLO, giải thích dễ hiểu qua bốn sự cố
Mình cho bốn sự cố giả lập chạy qua đúng bộ đánh giá SLO mà Belvador chạy mỗi phút. Trên cùng lưu lượng, cảnh báo theo ngưỡng kêu 16 lần chỉ vì một lỗi rò rỉ chậm.
Andrew Babo7 phút đọc
Kỹ thuật
Đừng báo động cho mọi exception: một ngày nhiều lỗi, bốn cách cảnh báo
Mình cho một ngày giả lập 2.268 lỗi chạy qua bốn chính sách cảnh báo. Mỗi event một cảnh báo thì gửi 2.268 tin; chính sách mà nhiều team cuối cùng chọn chỉ gửi 5 tin, và hai trong số đó vẫn là nhiễu.
Andrew Babo7 phút đọc
Đọc tiếp trong tài liệu
Xem lỗi production của chính bạn như thế này
Belvador chạy trên máy chủ Hetzner của chính bạn: lỗi, cron, uptime và trace — dữ liệu vẫn là của bạn.