

Burn rate trong SLO, giải thích dễ hiểu qua bốn sự cố
Mình cho bốn sự cố giả lập chạy qua đúng bộ đánh giá SLO mà Belvador chạy mỗi phút. Trên cùng lưu lượng, cảnh báo theo ngưỡng kêu 16 lần chỉ vì một lỗi rò rỉ chậm.
Andrew Babo7 phút đọc
Trong bài này
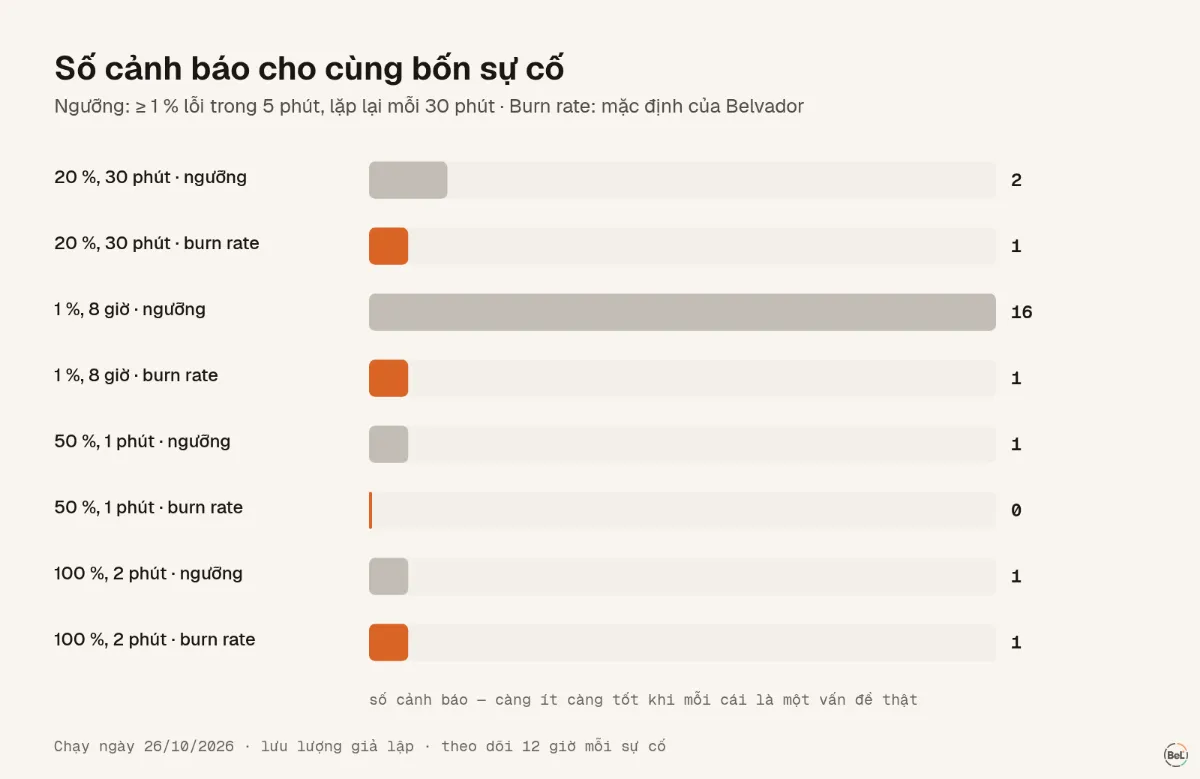
Cảnh báo burn rate kêu khi error budget của bạn đang bị tiêu nhanh, và nó kiểm tra điều đó ở hai cửa sổ cùng lúc. Cửa sổ dài cho thấy vấn đề đủ lớn để đáng quan tâm, cửa sổ ngắn cho thấy vấn đề vẫn đang diễn ra. Trong lần chạy lại bốn sự cố giả lập, nó kêu sau 5 phút với sự cố 20 % lỗi, bỏ qua lỗi chớp nhoáng một phút, và bắt được rò rỉ 1 % sau 3,6 giờ bằng một cảnh báo, trong khi luật ngưỡng 5 phút trên cùng lưu lượng kêu 16 lần.
Error budget và burn rate trong hai câu#
SLO 99,9 % availability trong 30 ngày cho phép 0,1 % request bị lỗi. Phần cho phép đó gọi là error budget: tương đương 43,2 phút sập hoàn toàn, hoặc ngần ấy request lỗi rải rác. Sách SRE workbook của Google định nghĩa burn rate là "how fast, relative to the SLO, the service consumes the error budget", tức tốc độ tiêu budget so với SLO. Burn rate bằng 1 nghĩa là tiêu vừa hết budget vào cuối cửa sổ; burn rate 14,4 nghĩa là tiêu 2 % budget của cả tháng chỉ trong một giờ.
Cách thiết lập mà workbook khuyên dùng, cũng là mặc định của Belvador, gồm ba luật:
| Mức độ | Cửa sổ dài | Cửa sổ ngắn | Burn rate vượt | Budget đã tiêu khi kêu |
|---|---|---|---|---|
| Page | 1 giờ | 5 phút | 14,4 | 2 % |
| Page | 6 giờ | 30 phút | 6 | 5 % |
| Ticket | 3 ngày | 6 giờ | 1 | 10 % |
Cả hai cửa sổ đều phải vượt ngưỡng. Cửa sổ dài giữ cho một đợt tăng vọt ngắn không làm ai bị gọi dậy; cửa sổ ngắn giúp cảnh báo đóng sớm sau khi đã sửa xong.
Cách mình chạy lại#
Con số trong bảng thì dễ đồng ý nhưng khó cảm nhận. Nên ngày 26/10/2026 mình viết một script nhỏ, đưa lưu lượng từng phút vào đúng bộ đánh giá mà tick SLO của Belvador đang chạy, và ghi lại mỗi lần cảnh báo mở hoặc đóng. SLO: 99,9 % availability trong 30 ngày, 100 request mỗi phút, không có lỗi nền, trước đó là một tháng sạch sẽ. Mỗi sự cố được theo dõi 12 giờ kể từ lúc bắt đầu.
Để so sánh, mình dùng luật mà nhiều team hay dùng lúc đầu: kêu khi có từ 1 % request lỗi trở lên trong 5 phút gần nhất, và nhắc lại mỗi 30 phút chừng nào điều kiện còn đúng.
| Sự cố | Budget đã tiêu | Cảnh báo burn rate | Cảnh báo theo ngưỡng |
|---|---|---|---|
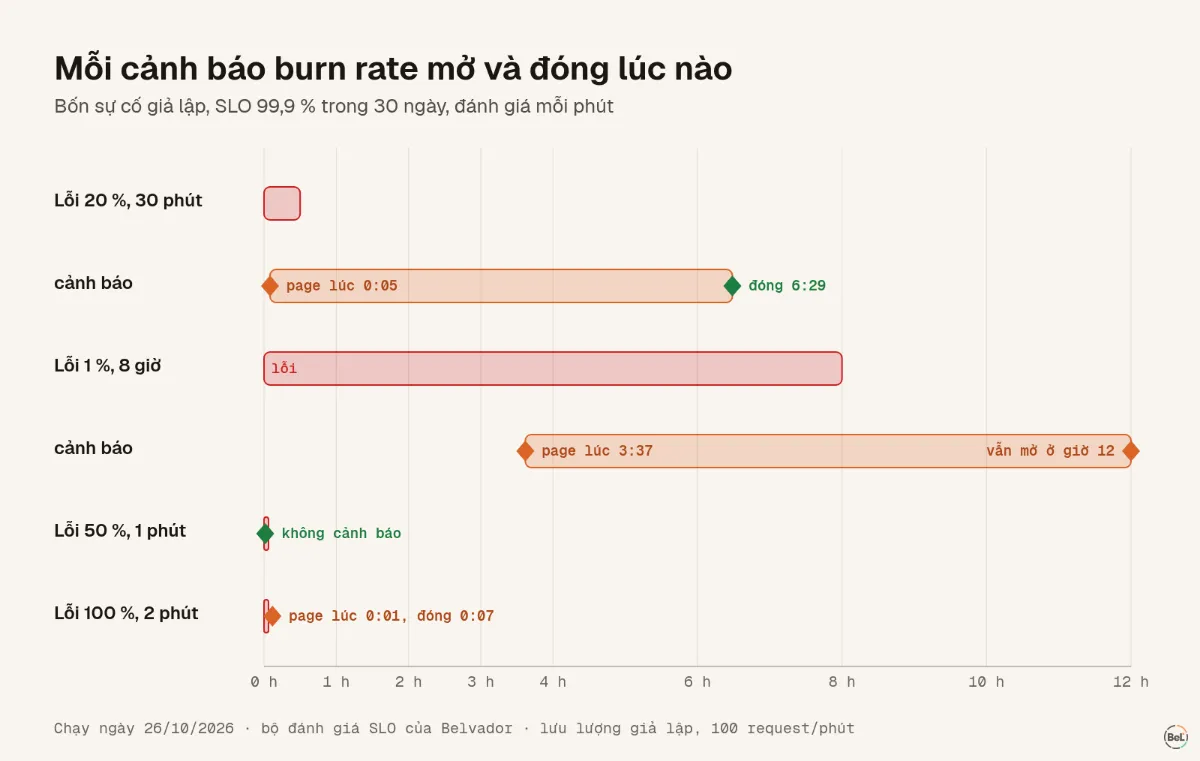
| 20 % lỗi trong 30 phút | 13,9 % | page ở phút 5, một cảnh báo, đóng lúc 6 giờ 29 phút | 2 |
| 1 % lỗi trong 8 giờ | 11,1 % | page lúc 3 giờ 37 phút, vẫn mở ở giờ thứ 12 | 16 |
| 50 % lỗi trong 1 phút | 1,2 % | không có | 1 |
| 100 % lỗi trong 2 phút | 4,6 % | page ở phút 1, đóng ở phút 7 | 1 |
Bốn sự cố cho thấy gì#
Sự cố thật thì kêu trong vài phút#
Với 20 % lỗi, burn rate một giờ vượt 14,4 sau năm phút: năm phút ở mức 20 % bằng 1,67 % lượng request của một giờ, tức burn rate 16,7. Cửa sổ năm phút thì vượt ngưỡng ngay từ phút đầu, nên page mở ở phút thứ năm.
Lỗi chớp nhoáng tốn ít budget thì không kêu#
Một phút với 50 % lỗi tiêu 1,2 % budget của tháng. Burn rate một giờ cao nhất chỉ 8,3, dưới 14,4, nên không có gì kêu. Luật ngưỡng thì kêu một lần. Lần kêu đó có đáng hay không là tuỳ bạn đánh giá, nhưng sách SRE nói rất rõ cái giá nếu đánh giá sai: "When pages occur too frequently, employees second-guess, skim, or even ignore incoming alerts". Bị gọi quá thường xuyên thì người ta bắt đầu lướt qua, rồi bỏ qua luôn.
Hai phút sập hoàn toàn thì khác: nó tiêu 4,6 % budget, và page mở ngay sau phút đầu tiên. Cảnh báo đóng ở phút thứ bảy, khi cửa sổ năm phút đã sạch, dù burn rate một giờ vẫn là 33. Đó chính là việc của cửa sổ ngắn.
Rò rỉ chậm là kiểu mà luật ngưỡng xử lý tệ nhất#
Tỉ lệ lỗi đều đều 1 % tương ứng burn rate 10. Nó không bao giờ vượt mức 14,4 của page nhanh, nên luật một giờ im lặng. Luật sáu giờ, với ngưỡng 6, mở page sau 3 giờ 37 phút, lúc rò rỉ đã tiêu khoảng 5 % budget.
Luật ngưỡng thì nằm ngay trên vạch 1 % suốt tám tiếng và cứ nửa giờ lại nhắc một lần: 16 cảnh báo cho cùng một vấn đề. Chẳng ai đọc tới cái thứ mười sáu.
Một cảnh báo, cho tới khi mọi cửa sổ đều ổn#
Sau sự cố 30 phút, cảnh báo burn rate vẫn mở thêm sáu tiếng rưỡi. Điều kiện page nhanh đã hết trong vòng một giờ, nhưng luật ticket ba ngày vẫn thấy budget đang bị tiêu cho tới khi cửa sổ ngắn sáu giờ của nó sạch. Belvador giữ tất cả trong một cảnh báo đang mở, thay vì đóng page rồi mở thêm ticket, và chỉ đóng khi mọi luật của mức đó đều được đánh giá là ổn. Thiếu dữ liệu không bao giờ làm cảnh báo tự đóng.
Chọn SLO để đặt cảnh báo#
Phương pháp chỉ tốt bằng chỉ số nằm bên dưới nó. Vài nguyên tắc đứng vững với team nhỏ:
- Đo thứ người dùng cảm nhận được. Availability của luồng request chính, hay các lần chạy của một job định kỳ, tốt hơn CPU hay độ dài queue.
- Bắt đầu ở 99,5 % hoặc 99,9 %, đừng nhảy lên 99,99 %. Budget một tháng của bốn số 9 chỉ có 4,3 phút, một lần deploy chậm là tiêu hết.
- Bảo đảm chỉ số có đủ lưu lượng. Khi lưu lượng rất ít, một request lỗi đã chiếm phần lớn cửa sổ, và cảnh báo sẽ giật cục dù ngưỡng đặt thế nào.
- Gửi page và ticket tới hai nơi khác nhau. Page phải gọi được người dậy; ticket thì chờ tới sáng được.
Với job chạy theo lịch, kiểu hỏng nguy hiểm nhất là im lặng, không có lỗi nào để đếm; bài cron job chạy mãi không xong nói về chuyện đó. Nếu bạn đang chuyển từ Sentry sang, checklist chuyển từ Sentry SDK giúp kiểm từng giả định trước khi dựa vào cảnh báo mới.
Belvador giúp ở đâu#
Belvador đánh giá SLO mỗi phút trên dữ liệu uptime check, lần chạy monitor, ping URL hoặc trace span, với ba luật ở trên làm mặc định. Bạn chọn SLO gửi page, ticket, cả hai hay không gửi gì, và có thể tắt tiếng cảnh báo trong lúc bảo trì. Tài liệu cảnh báo SLO liệt kê các luật và nội dung tin nhắn, tổng quan SLO giải thích các chỉ số, còn trang cảnh báo cho thấy page và ticket được gửi đi đâu.
Đọc tiếp#
Thuộc bài hướng dẫn: Observability cho team nhỏ: năm tín hiệu, theo đúng thứ tự cần dùng
Bài liên quan
Mọi bài viết
Hướng dẫn
Observability cho team nhỏ: năm tín hiệu, theo đúng thứ tự cần dùng
Team hai người chưa cần cả một nền tảng metrics. Cái cần là biết khi người dùng gặp lỗi, khi một job ngừng chạy, khi trang web sập, và sau này là khi người dùng có một tuần tệ.
Andrew Babo7 phút đọc
Kỹ thuật
Đừng báo động cho mọi exception: một ngày nhiều lỗi, bốn cách cảnh báo
Mình cho một ngày giả lập 2.268 lỗi chạy qua bốn chính sách cảnh báo. Mỗi event một cảnh báo thì gửi 2.268 tin; chính sách mà nhiều team cuối cùng chọn chỉ gửi 5 tin, và hai trong số đó vẫn là nhiễu.
Andrew Babo7 phút đọc
Đọc tiếp trong tài liệu
Xem lỗi production của chính bạn như thế này
Belvador chạy trên máy chủ Hetzner của chính bạn: lỗi, cron, uptime và trace — dữ liệu vẫn là của bạn.